@recraftai
Recraft Studio 接入三款模型
两款视频模型和一款图像模型加入同一工作台。
Recraft 在 Studio 新增 Flux 3 Video Max,用于快速生成视频初稿;Kling 4.0 可制作最长 30 秒的有声场景;Bria 的 Fibo 2 则用于生成图像,Recraft 称其训练数据均获得许可。
@tri_dao · 转引 @AlpinDale
开发者展示 BF16 权重的 12 位无损压缩
Tri Dao 转发了 AlpinDale 的演示:基于 Together AI 的 NyoomFloat12,用 12 位无损表示 BF16 模型权重。这是对权重表示的压缩,原帖没有给出整套推理系统的显存或速度测试。
@PixVerse_
PixVerse 用一条线指定穿越镜头
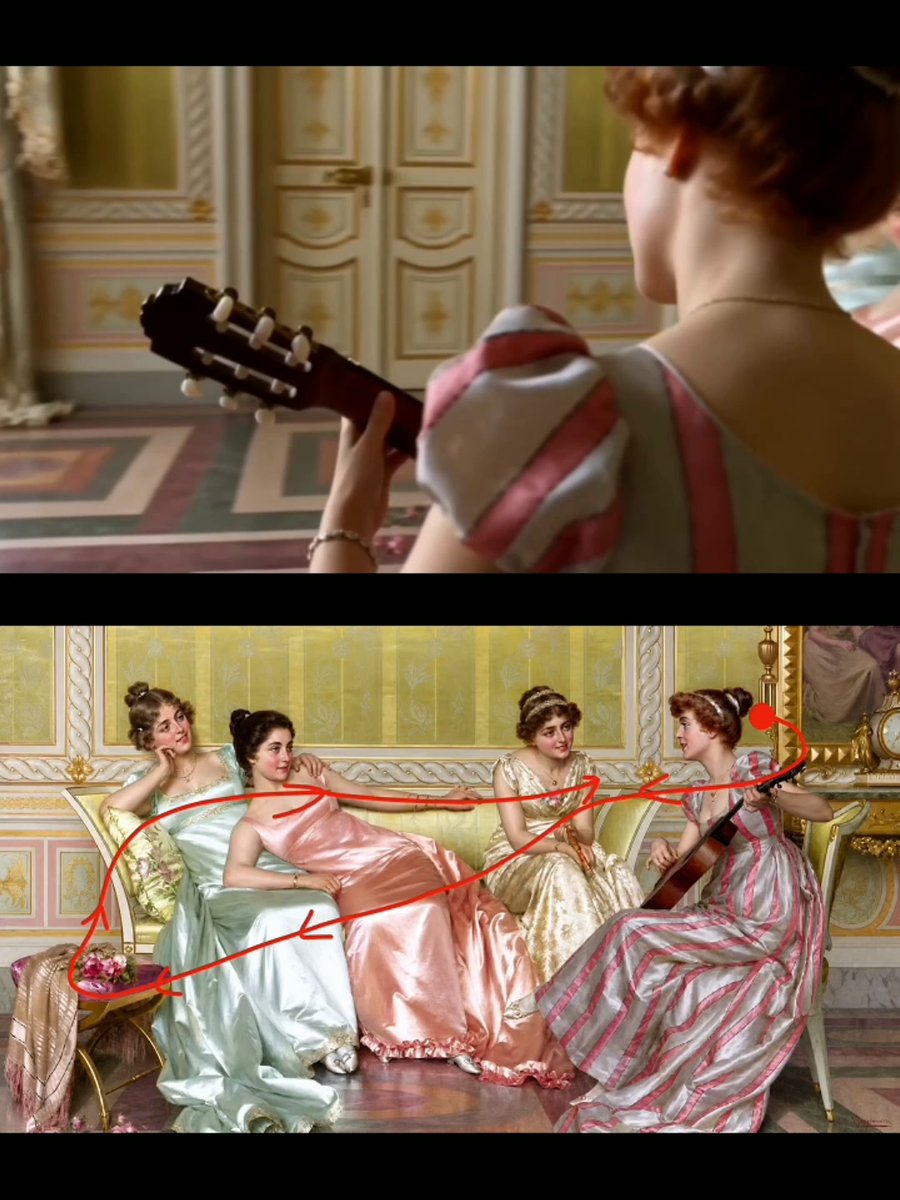
用户在静帧上画一条红线,就能为第一人称镜头指定路径。官方演示用这种方式生成穿越场景的镜头,无需手工逐帧设置关键帧。
@lateinteraction · 转引 @DSPyOSS
ShipStation 让服务台智能体查 Slack 历史
DSPy 转述 AWS 案例称,ShipStation 的 AI IT 服务台用 dspy.RLM 把 Slack 历史作为查询上下文。这让智能体可以利用此前的团队讨论来处理问题。
@robertskmiles
网站该让谁的助手来操作
“我想在你的网站上用我自己的 AI 助手。”(译)
AI 安全科普作者 Robert Miles 提出一种产品诉求:网站可以让用户自己的助手通过浏览器操作服务。
插件作者转述 DeepSeek Harness 日活
设计插件作者歸藏称,DeepSeek Harness 团队推荐了他的插件,并转述该产品日活超过 154 万。此处数字来自作者的转述。
Perplexity 创始人谈 Teammates 的执行框架
Aravind Srinivas 将 Teammates 的设计归纳为两点:智能体任务流程主要通过代码运行,模型选择也不绑定单一模型。
Grok Bot 正在做 token 效率优化
马斯克称团队正在改进 Grok Bot 的 token 使用效率和行为表现。帖子没有给出上线日期或量化结果。
Latent Space 讨论 GitHub 如何适配智能体
播客讨论智能体参与软件开发后,GitHub 的工作流和平台设计如何变化。
给人看得懂的智能体验收证据
Dotey 以修复评论问题为例,建议交付时附上能展示关键操作和结果的截图或录屏,方便人类独立验收。
面向模型的 API 也要考虑训练分布
Teortaxes 分享初步判断:对权重冻结的模型,熟悉的接口模式可能比为智能体新设计的 API 更好用。这个说法来自个人实验经验。
Tinker 分享一个训练迁移案例
Tinker 转述称,一位研究者此前租用 GPU 花了 4,600 美元仍未完成任务,改用 Tinker 后进度加快。该个案未给出对照成本。
独立开发者用 AI 改造站点国际化
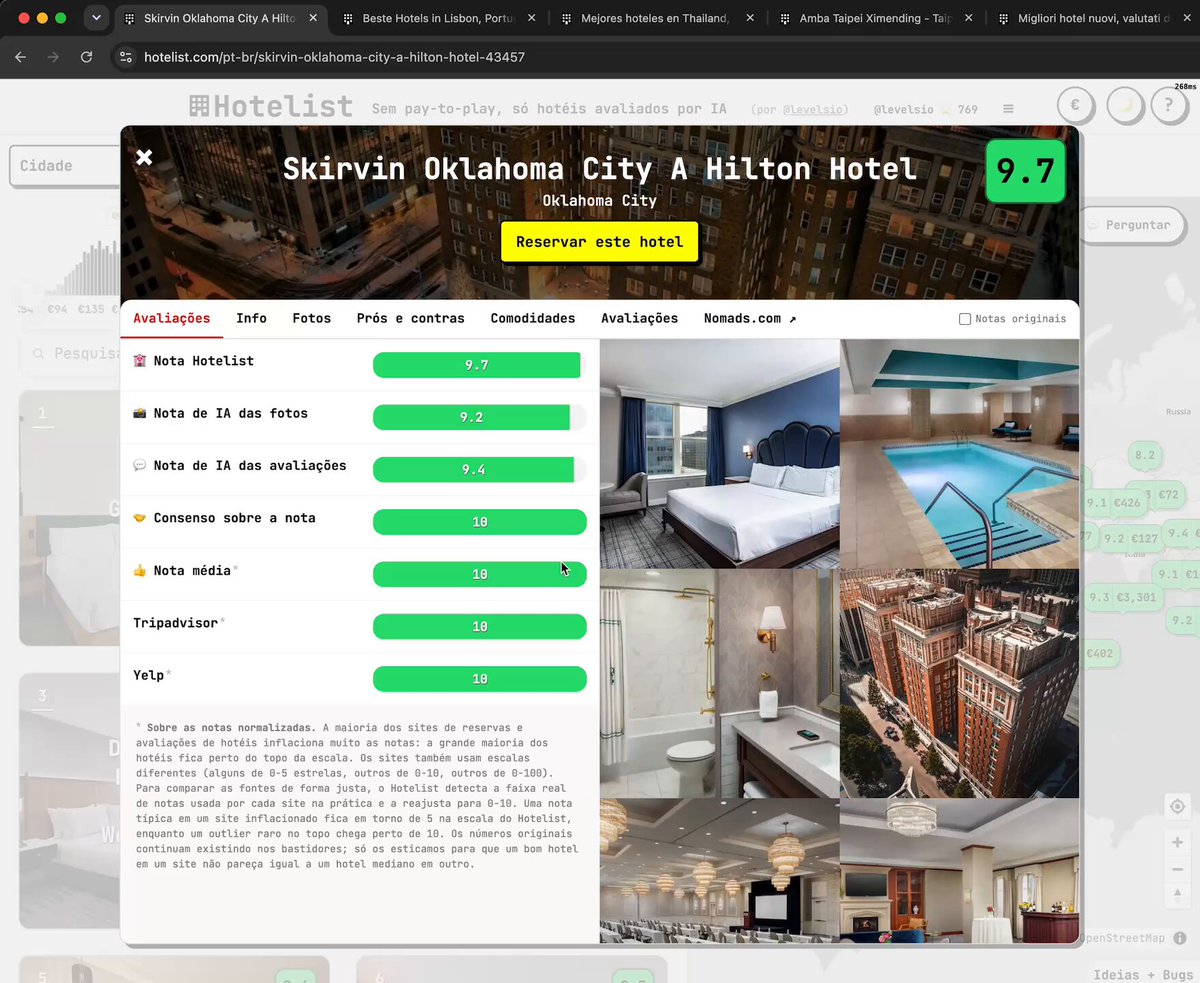
Levelsio 说,过去需要在代码里为每段文案接翻译函数,维护成本让他搁置了国际化;他现在尝试用 AI 来处理这类改造。
用户分享 Claude Code 排查冷门问题的经历
一位自称对 AI 持怀疑态度的用户称,Claude Code 用不到一小时解决了一个缺少文档的问题。原帖描述的是单次经历。
回看 Claude 科研会话的用途
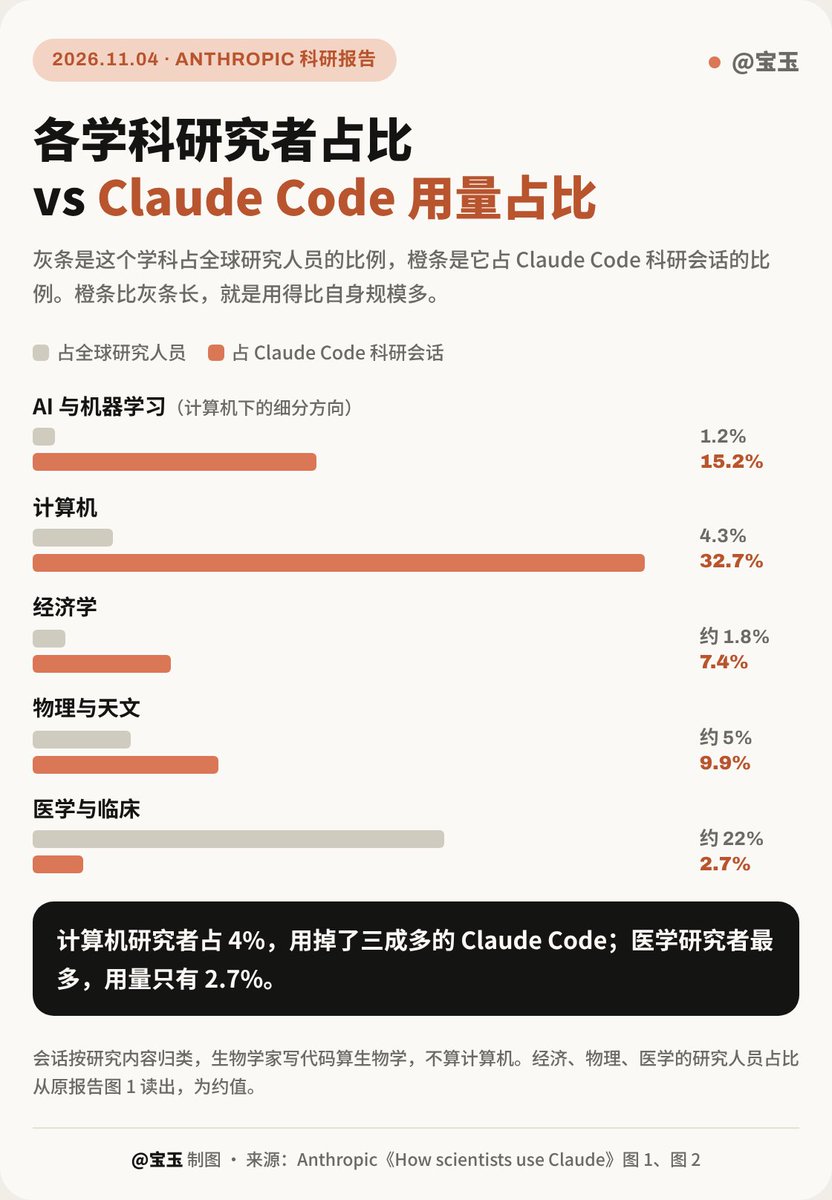
Dotey 转述 Anthropic 对约 20.7 万次科研相关 Claude 会话的分析:常见任务包括数据分析和论文写作,提出研究想法的使用频率较低。
回看 Claude 跨会话记忆如何整理
Anthropic 此前介绍了跨会话记忆的难点:智能体在任务中要提前判断哪些信息值得保存。Dotey 的解读聚焦后台“做梦”步骤如何在会话后复查和整理记忆。
研究者点评 Inkling 2 回归 ViT
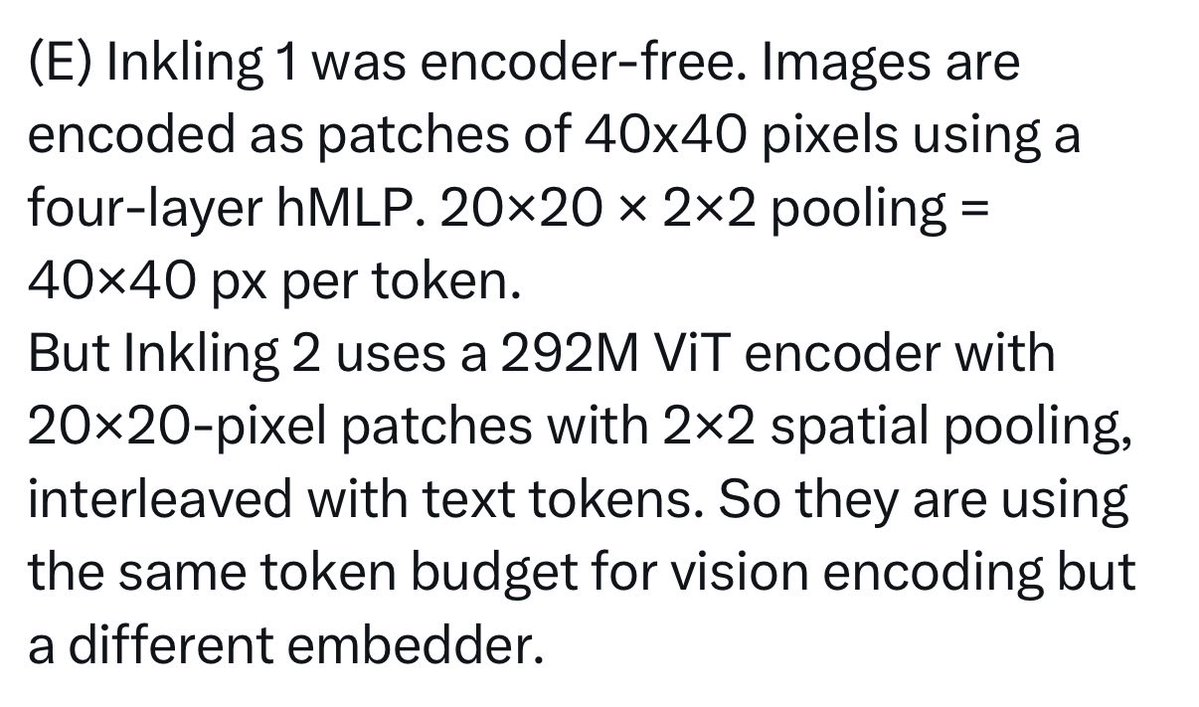
Giffmana 认为,早期方案在图像块上做多层处理时缺少跨块信息;他赞成 Inkling 2 使用视觉 Transformer 编码器。
腾讯 DSpine 引发投机解码讨论
Teortaxes 转述了对腾讯 DSpine 的正面评价,建议关注投机解码的读者查看技术细节。帖子没有给出可横向对照的性能数字。
SGLang 公布峰会分组会议
LMSYS 主办的 SGLang Summit 将于 11 月 12 至 13 日在旧金山 Fort Mason 举行。持 Expo Pass 的参与者可以参加分组会议。
LeCun 澄清 JEPA 的预测目标
LeCun 解释,JEPA 中的 P 指 predictive,并把讨论重点放回联合嵌入与生成式建模的区别。
“苦涩的教训”被用来讨论模型自我改进
Graham Neubig 给出自己的解读:Sutton 的文章不等于为单纯扩大规模背书,他认为原文也能支持递归自我改进的方向。
LeHami 被用作物理约束世界模型的案例
The Turing Post 以 LeHami 为例讨论如何用物理知识改进世界模型,LeCun 转发了这篇解读。
用模型给审稿意见做一次自查
François Fleuret 建议把论文和审稿意见交给模型,帮助发现可能站不住脚的批评,供审稿人复核。
Fleuret 质疑把低交叉熵等同于学会任务
他认为模型可能依赖训练目标奖励的统计捷径,提出应关注模型在自身归纳偏置之外还能学到什么。
Shizuku-Duplex 面向 AI 角色的双向语音
Shizuku AI Labs 介绍了一款面向 AI 角色的全双工音频合成模型,设计目标是在互动中同时处理双方的语音。
RGBMoCap 用手机视频提取三维人体动作
创作者展示了一套工作流:从单目实拍视频估计 SMPL 或 SMPL-X 人体网格,无需穿戴式设备,再把动作接入可控视频生成。
动作捕捉接上角色替换 LoRA
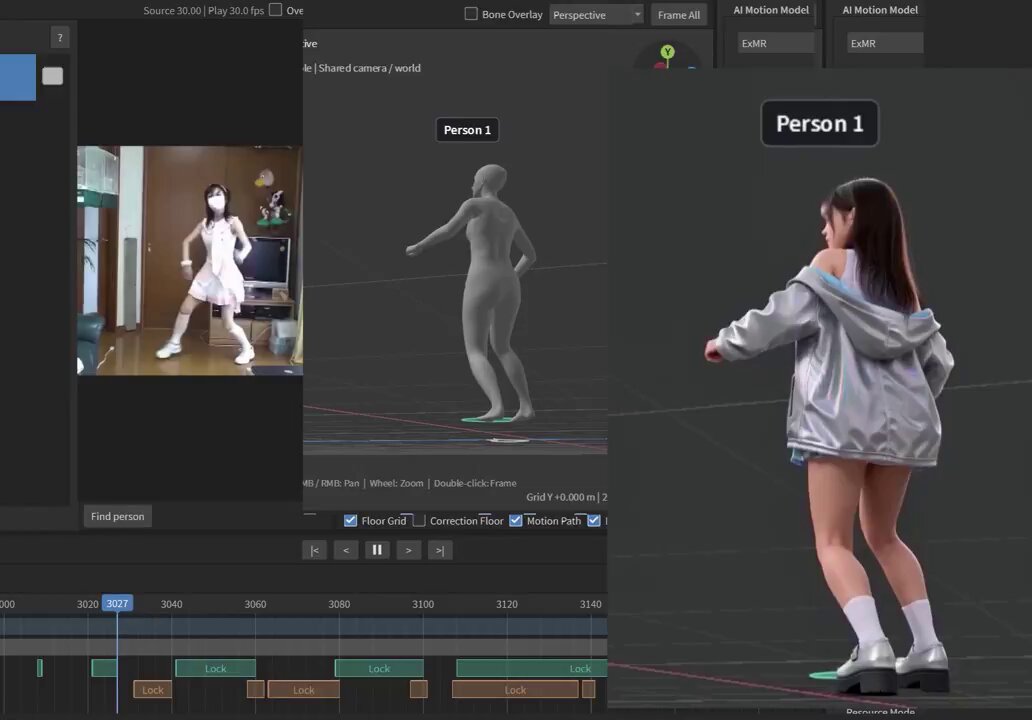
另一段演示把 RGBMoCap 和 H3 角色替换 LoRA 串起来,让实拍动作可以用作角色替换的输入。
Infinite Slop TV 结束连载
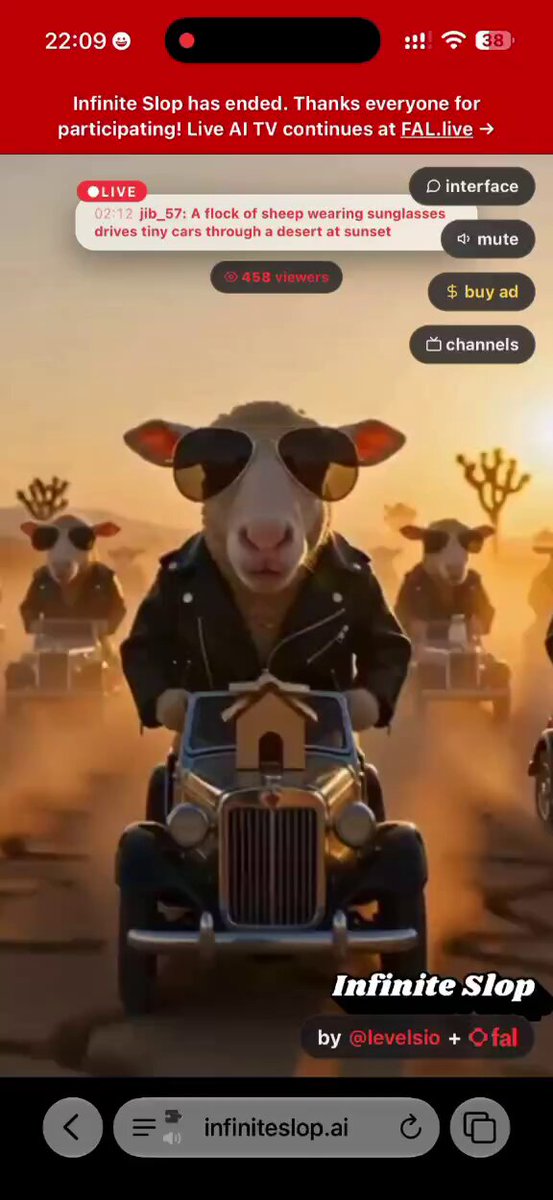
Levelsio 宣布项目已结束。它曾让观众在聊天室输入内容,再把输入送入持续生成的 AI 视频直播。
创作者分享 AI 动画项目第二周数据
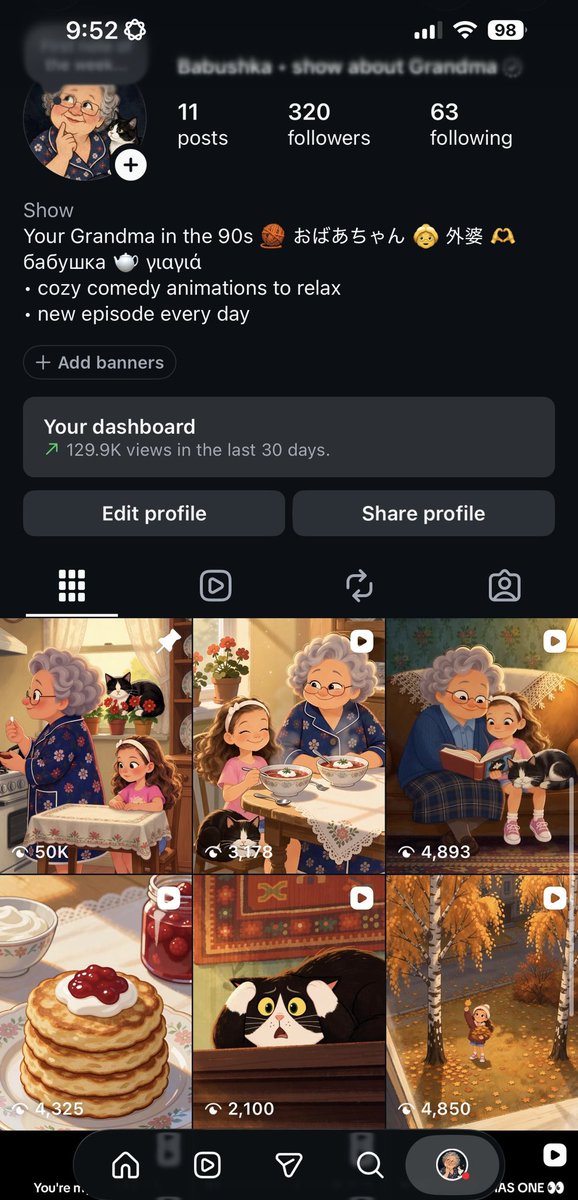
创作者自报已发布 11 支视频、获得逾 13 万次播放,正整理声音设计、Seedance 2.5 和短视频开场的教程。
先用 Blender 做运镜,再让模型跟参考
创作者建议用 Claude 辅助生成 Blender 场景和镜头运动,导出参考视频后交给 Seedance 2.5。
一位开发者试接 Blender MCP 和 vork
Teortaxes 分享了一次集成尝试:用插件和连接器让 Blender MCP 与 vork 配合。帖子记录的是一次实际试接。
CoffeeVectors 展示 AI 音乐视频
创作者分享了用 Seedance 2.5、Astra 和 Suno 参与制作的音乐视频。
英伟达称 SimReady 资产下载过百万
NVIDIA Omniverse 称,Hugging Face 上的 SimReady 三维资产下载量达到 100 万。这些资产供兼容的仿真工具复用。
Jim Fan 预告自主机器人演示
Jim Fan 预告将展示一镜到底的实时演示,称画面中的实体机器人会自主运行。原帖没有展示结果。
Figure 分享 F.03 人形机器人影像
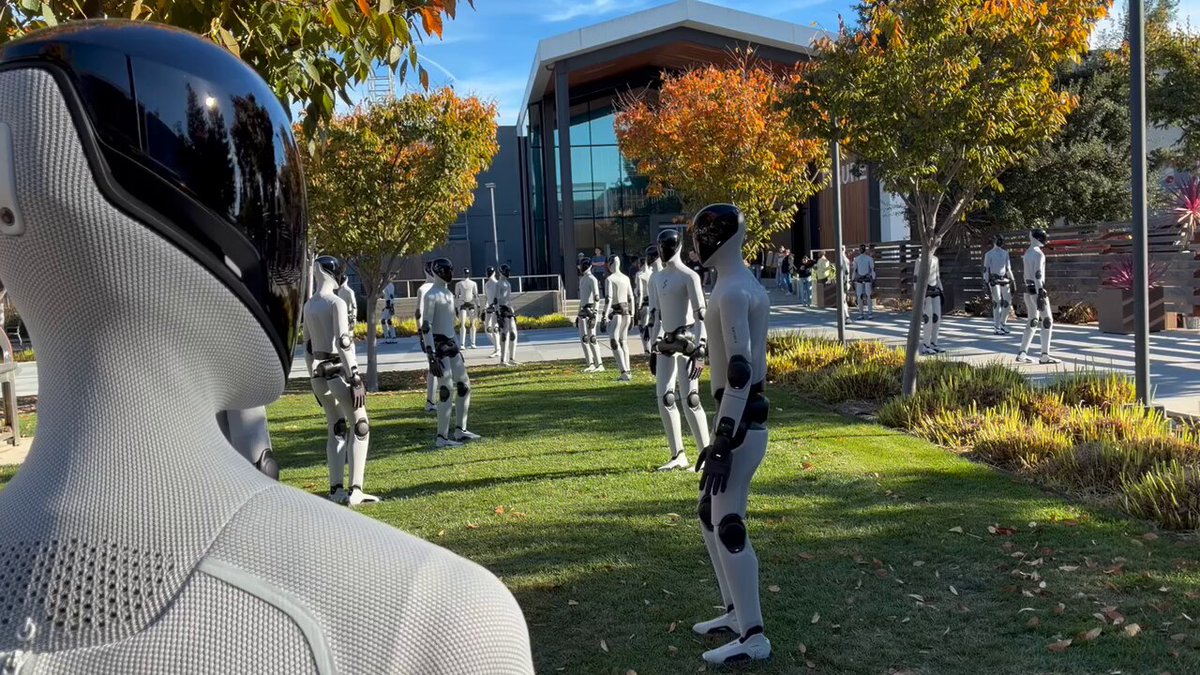
Figure 创始人 Brett Adcock 分享了 F.03 的影像。帖子未交代任务条件或自主程度。
开发者讨论用高斯泼溅渲染界面
Bekhovsgun 从实验室的空间演示出发,提出一个问题:高斯泼溅除了呈现三维场景,能否也用来渲染用户界面?
Backrooms 浏览器模拟器用 Opus 5.5 构建
项目页把 Dimension 9 描述为会持续演化的 Backrooms 模拟器,可在电脑或手机浏览器里与朋友一起探索。
开发者把 iPhone 变成 Mac 输入设备
一位开发者称借助 Claude 做出了演示,让 iPhone 同时充当类似 Wii 的动作遥控器和 Mac 触控板。
姚顺雨谈产品壁垒:数据与上下文
据 Dotey 转述,姚顺雨在回应张亚勤时称,AI 产品的壁垒更多在产品层,尤其是独有的数据和用户上下文。
AlphaXiv 对照新兴 AI 实验室融资与引用
AlphaXiv 汇总了 32 家实验室的融资情况及创始团队论文引用,称样本累计有 835 万次引用。引用数是这组样本的统计指标。
创作者分享 Firefly 上的 Seedance 2.5 体验
一位经常在多个平台同时生成视频的创作者说,她在 Firefly 上用 Seedance 2.5 时感到速度较快。她未提供同设置下的计时对比。
从一张照片起步做时尚组图
创作者演示了如何用头像或一张普通照片做输入,生成一组时尚编辑风格的图像。