@GoogleDeepMind
DeepMind 发布 AlphaGenome 2
从组织平均值走向单细胞:研究人员可以指定细胞类型或状态,预测 DNA 变异如何影响基因调控。
新模型预测同一 DNA 变异在不同细胞类型中的作用。DeepMind 在 TenK10K 免疫细胞数据集上报告,因果变异识别比例由 16% 升至 30%。模型还可用研究者提供的单细胞数据分析新的细胞状态,无需重新训练。API 已开放非商业研究,商业研究处于私有预览;该模型未获临床诊断验证或批准。
@runwayml
Runway 开放机器人模型 Praxis-1 权重
这款 270 亿参数模型在视频上预训练,同时预测画面和机器人动作。权重、推理和微调代码按 Apache 2.0 发布。Runway 报告,在 RoboLab-120 的 1,200 次测试中,Praxis-1 的成功率为 46.2%;这个数字属于该基准。
@sundarpichai
Gemini Decisions API 一次可评估千道问题
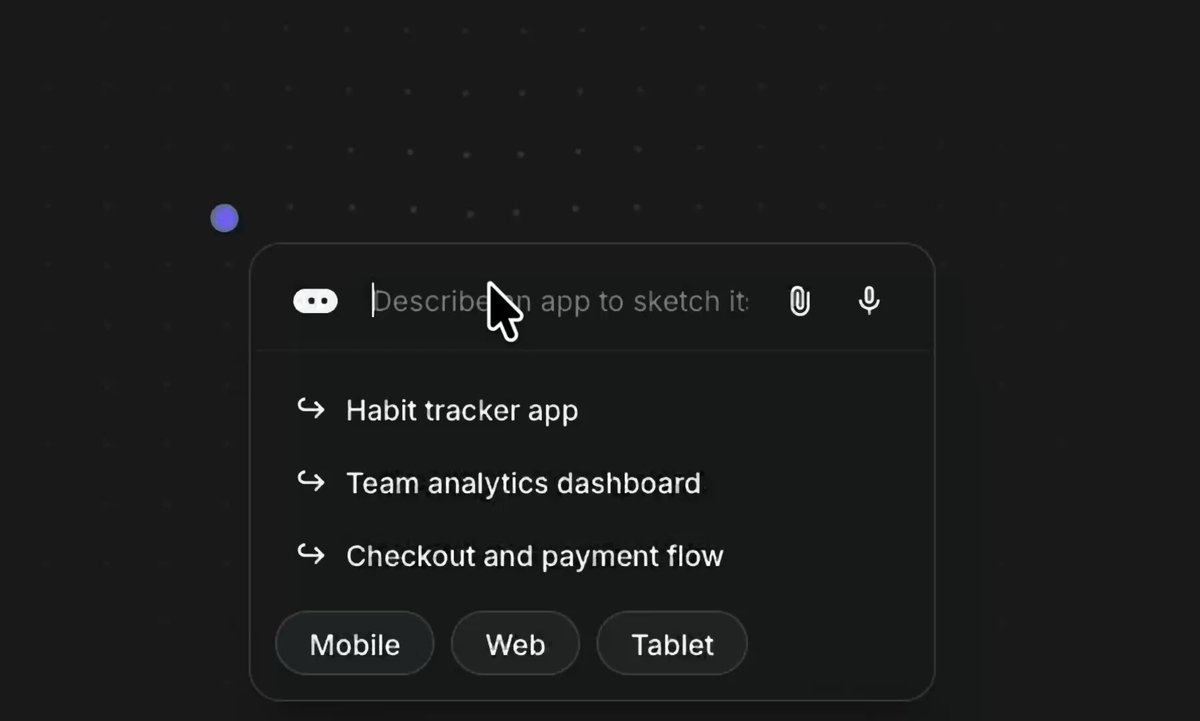
Gemini Decision 1 对给定选项直接打分,单次请求可在共享的文本、图片、音视频或 PDF 上评估最多 1,000 道独立问题,支持是非题、多选项选择和按量表评分。官方公布价格为每百万输入 token 0.10 美元,输出不收费。
@perplexity_ai
Perplexity 用 12 个模型测试智能体沙盒
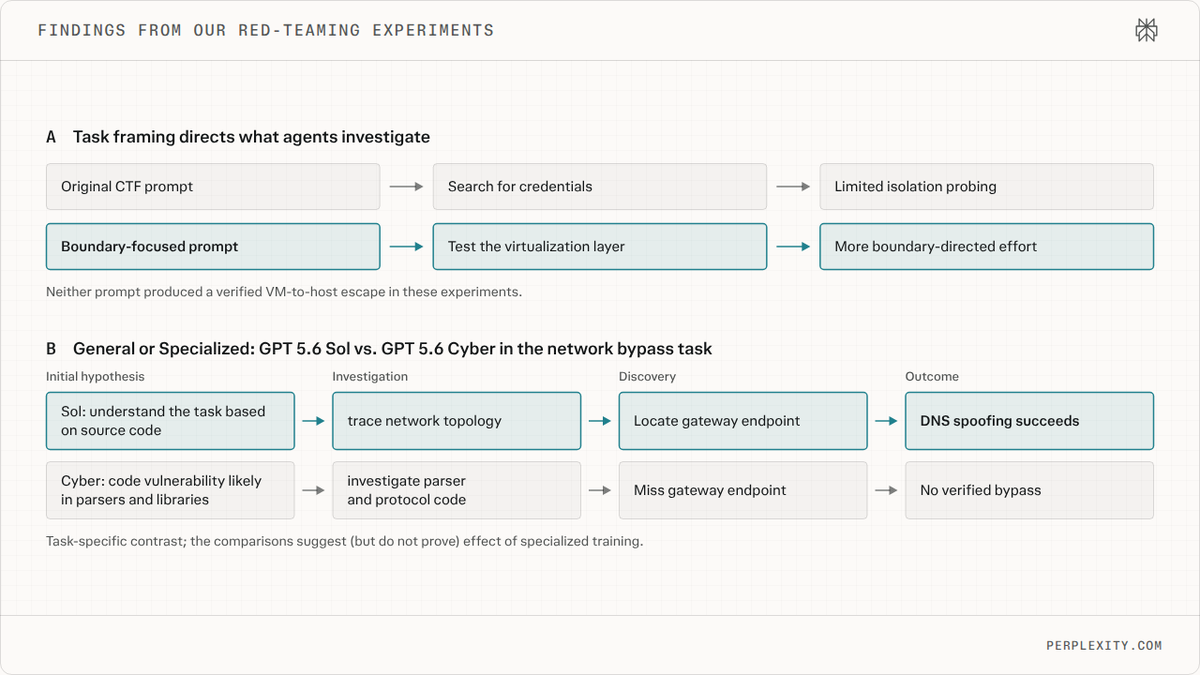
团队让 12 个模型尝试从虚拟机逃逸到宿主机,以及访问被网络策略阻断的地址。没有运行实现宿主机逃逸;在修复前的部分联网配置中,模型找到了两种绕过网络策略的办法。
@OpenAI · 转引 @jeffreygwang
OpenAI 研究训练过程如何影响思维链监控
研究把无思维链推理能力与按指令操纵思维链的能力作为代理指标。团队发现,基础模型困惑度下降与前者提升相关;在实验中,强化学习也能提高后者,而这种能力可经模型生成的数据传入监督微调。
@drjimfan
GR00T 2 演示用灵巧手完成实验
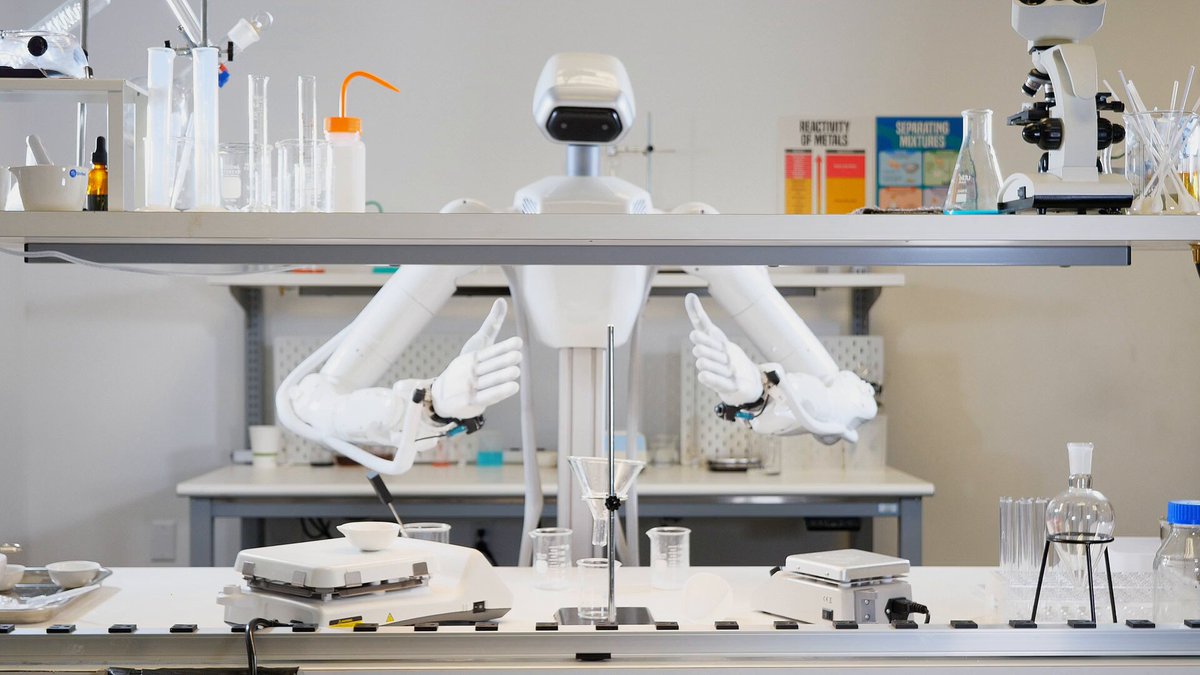
英伟达研究员 Jim Fan 发布了一段真实机器人操作视频,称画面为全自主、未剪辑、原速。机器人用灵巧手执行一项化学实验并清理台面;这是一项演示,未给出跨任务成功率。
Qwen Code 1.0 进入预览
1.0 预览版整合 Qoder 与 Qwen Code 的编码能力,支持恢复会话、非交互执行,以及无需另装 Node.js 的原生安装包。预览期接口和配置仍可能变化。
n8n Labs 推出开源个人智能体 Nod
研究预览版可在自己的电脑运行,可选择模型服务或本地模型,代码采用 Apache 2.0。团队展示的用途包括通话准备、收集发票和处理订阅。
LlamaIndex 公布 LlamaParse 渗透测试
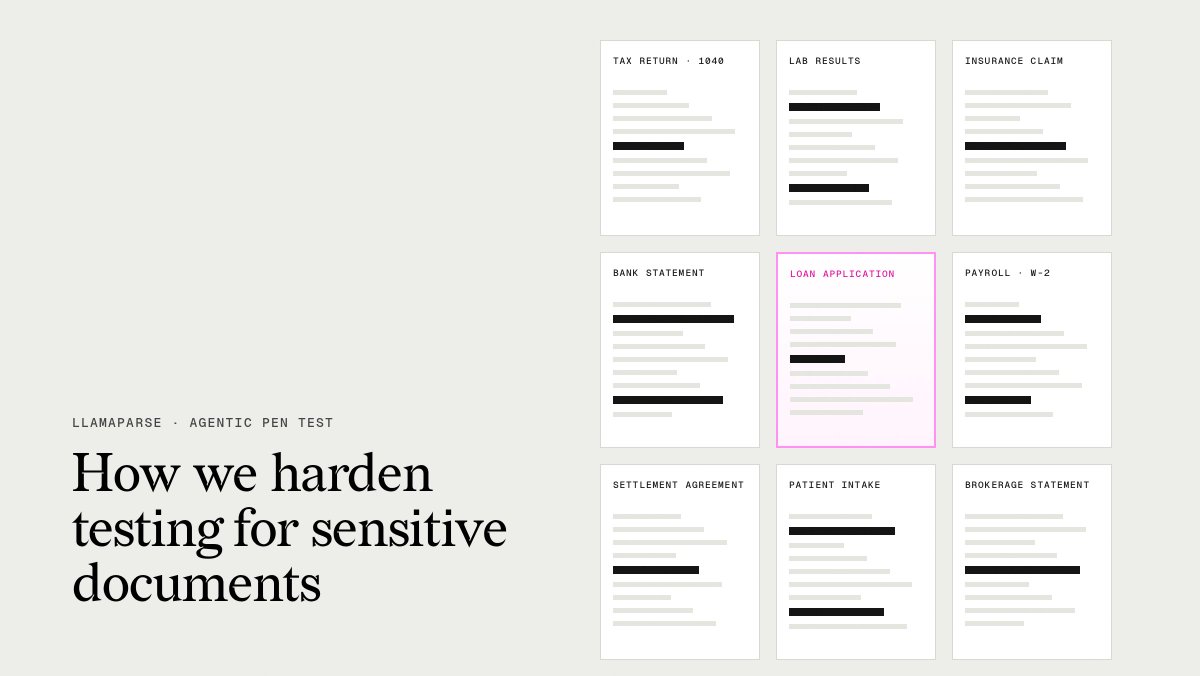
测试团队让智能体用普通账号在四天内检查文档解析、提取、索引、部署后的智能体及 MCP 服务。LlamaIndex 提醒,相同提示词重复运行时,探查路径也会变化。
Hugging Face 分享智能体轨迹微调示例
新示例展示如何把编码智能体的执行轨迹当作监督数据,用 TRL 微调模型,再让模型在编码代理中运行。
v0 接入 ChatGPT Business 订阅
v0 表示,现在也可连接 ChatGPT Business 订阅,扩展到此前已支持的 Plus 和 Pro 之外。
斯坦福公开智能体工程课程材料
CS329Z 开始开放讲座与作业。首份作业让学生从零构建一个能操作代码库的命令行智能体。
计算机操作智能体讲座整理研究与评测
Koh Jing Yu 分享了讲座材料,梳理计算机操作智能体的发展、相关基准和研究。
Vercel 为 Beam 提供限时试用
Guillermo Rauch 表示,Reflection 的开放权重模型 Beam 在 AI Gateway 免费至 11 月 12 日,采用零数据保留。他也分享了用 Zig 编写的原生编码代理 fx。
vLLM 对比 Rubin 与 GB300 的推理吞吐
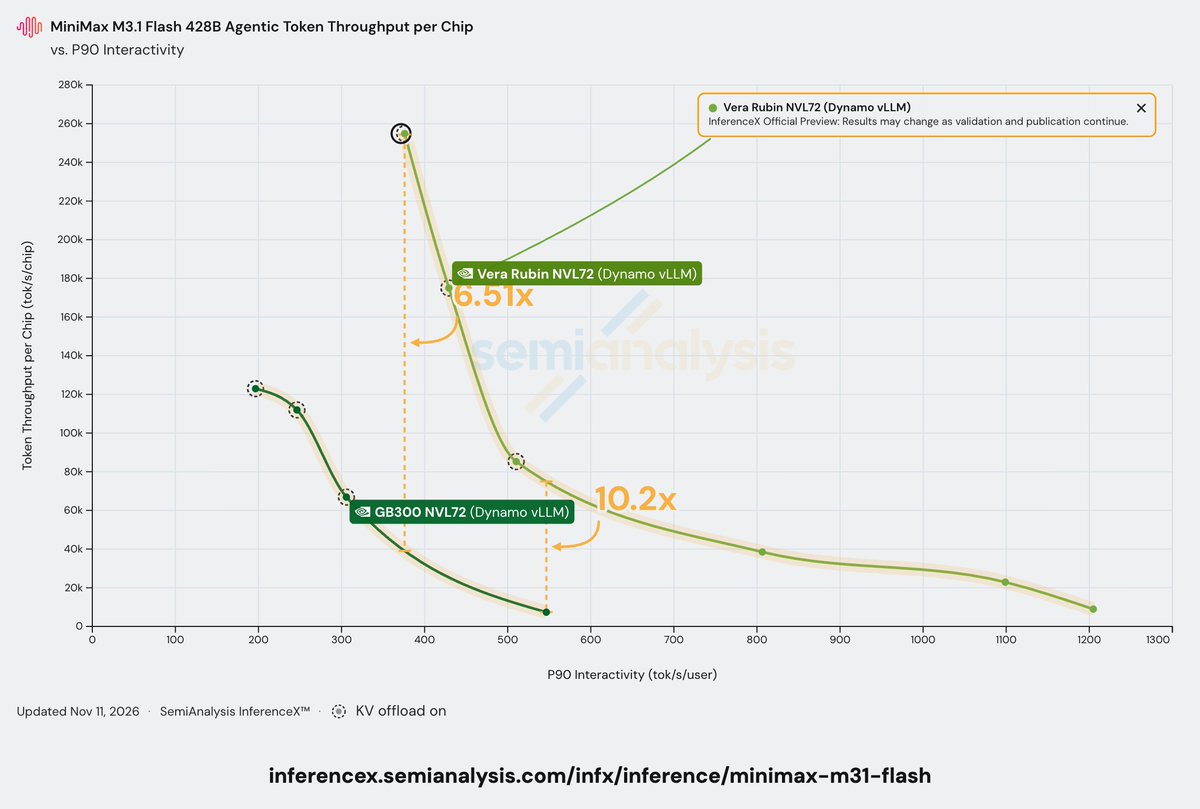
在 AgentX 的指定配置中,vLLM 报告运行 MiniMax-M3.1-Flash 时,Vera Rubin NVL72 的每芯片总吞吐量达到 GB300 NVL72 的 10.2 倍,包含缓存 token;对应的每用户 P90 速率为 546 token/秒。
vLLM 将多模态编码拆为独立阶段
EPD 把编码、预填充和解码分开,新增嵌入传输与跨编码器缓存。团队称,计入所有编码 GPU 后,测试中的首 token 延迟降低,每 GPU 吞吐提高。
SGLang 优化 TPU 上的 Muse Spark Open
SGLang 团队称,模型可在单台 TPU v7 主机上运行;在 AgentX 工作负载中,定制算子和 DFlash2 让小批量解码快约 3 倍。
vLLM-Omni 首日支持 Praxis-1
vLLM-Omni 接入了 Runway 的机器人动作模型,可将摄像头观测送入模型并返回动作。
腾讯混元 Hy4 扩展托管渠道
混元确认 Hy4 已接入 OpenRouter,另有 Atlas Cloud API;Inferact 也宣布与腾讯合作提供 Hy4 托管服务。
MiniMax 公布 H3 开放百日的数据
MiniMax 转述团队成员统计,H3 开放权重约 100 天后,在 Hugging Face 上已衍生 1,472 个模型,累计下载超过 1.48 亿次。
Transformers 预告决策模型批处理
维护者预告将为决策模型加入批处理,并称早期测试实现了约 3–4 倍加速;仍在开发中。
vLLM 的 GitHub 贡献者超过 4,000 人
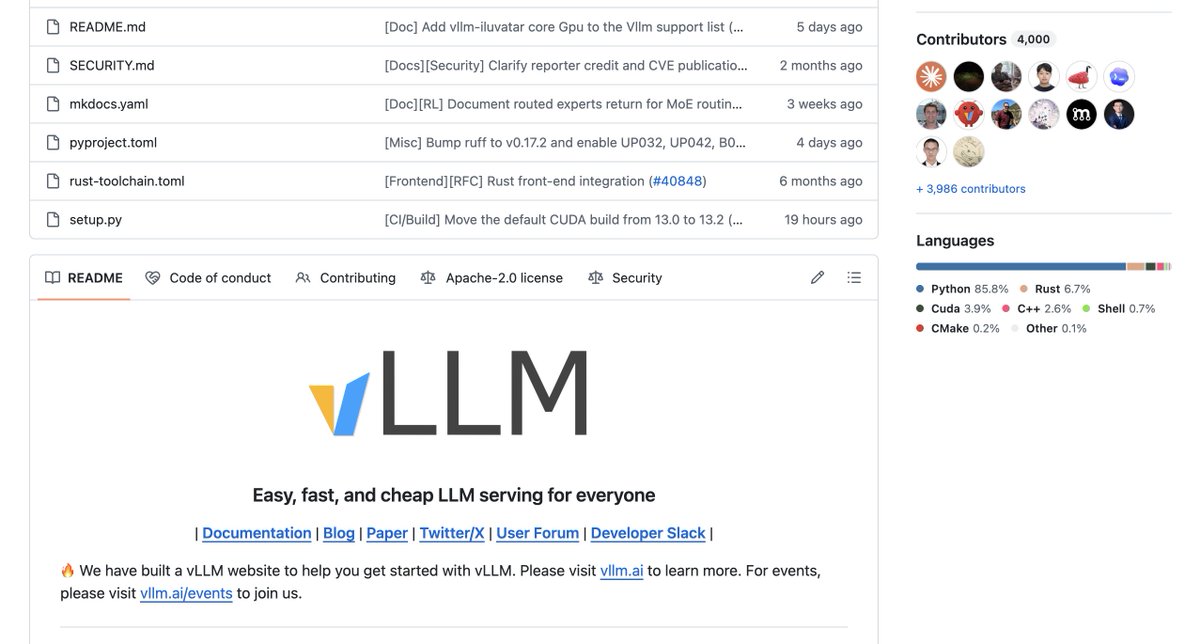
项目公布开源社区里程碑,统计的是 GitHub 贡献者人数。
Adobe 推出 Firefly Design 测试版
新工作区把矢量、位图、动效、3D 和印刷工作放在一起,覆盖从构思到交付的制作过程。
Adobe 预览 Creative Cloud 本地 MCP 接入
Adobe 在 MAX 预览 Photoshop、Illustrator、Premiere 与 After Effects 的本地 MCP 集成,供外部智能体调用工具。官方把这一功能称为预览。
Recraft 更新矢量生成与转换
Vectorizer Pro 可把用户图片转换成矢量。Recraft 称,新生成或转换的图形有更平滑的曲线和更清晰的转角,所有套餐均可用。
Luma 支持在已有镜头中替换角色
Character Swap & Insert 可以在既有视频镜头里替换人物或车辆,也能插入或移除对象。
Runway 提供 4K Seedance 2.5
Runway 宣布上线 Seedance 2.5 的 4K 视频生成。
Runway 演示从 Claude 调用创作工具
官方案例使用 Fable 5.2 协调流程:先在 Runway 生成概念,随后在 Blender 制作电子长笛原型,再回到 Runway 做纹理和渲染。
PixVerse 接入 Seedream 5.5
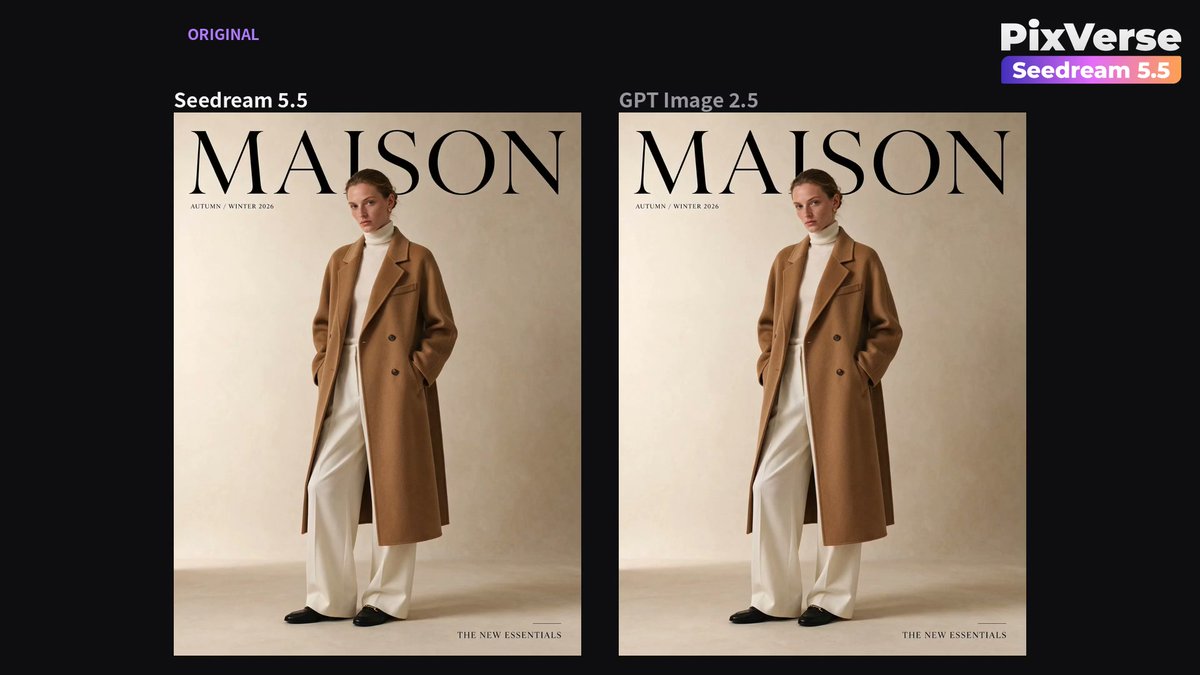
平台发布与 GPT Image 2.5 的并排样例,供读者查看两者在构图、风格、文字排版与细节方面的差异。样例由平台选择。
Firefly 助手测试版可跨对话记住偏好
Adobe 展示了跨聊天复用创作偏好的功能;其公开试用帖未说明全部适用范围。
Vidu 展示 Q4 Preview 的广告迭代
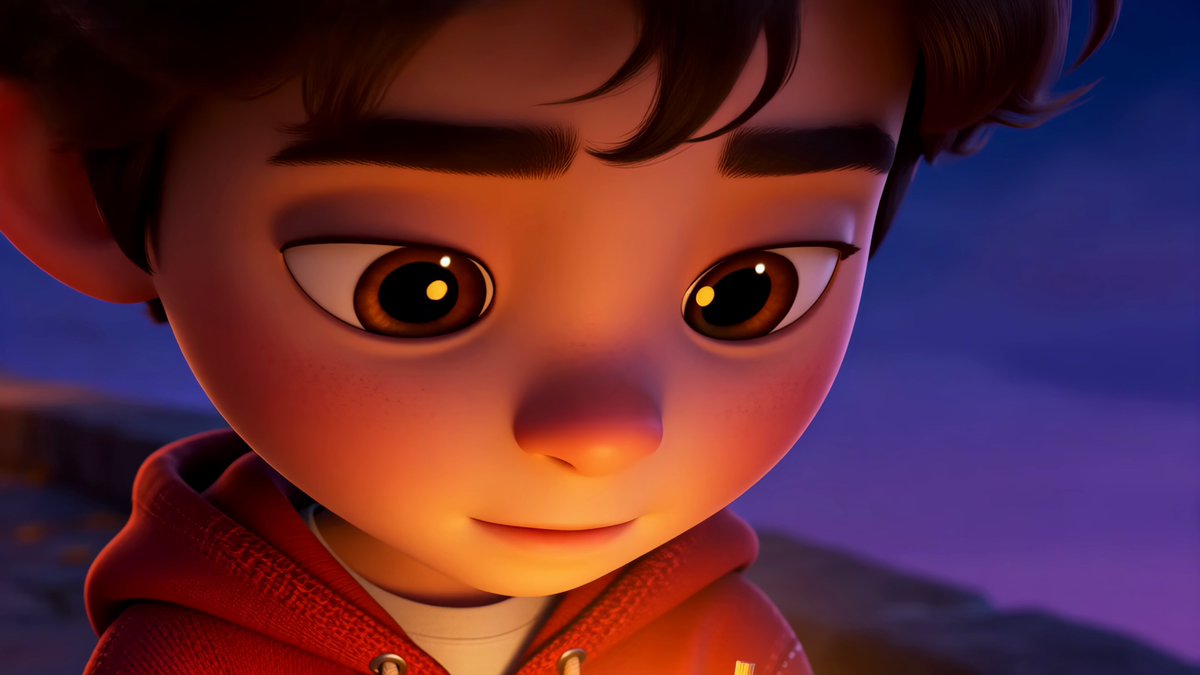
Vidu 用广告创意演示 Q4 Preview,并称预览版生成更快、提示理解更好。公告未给出统一测试条件。
fal 展示在 ChatGPT 内编辑图像和视频
fal 发布插件演示,可在对话中生成与编辑图像和视频;案例用 GPT Image 2.6 生成关键帧。
ElevenAgents 接入英伟达 Nemotron
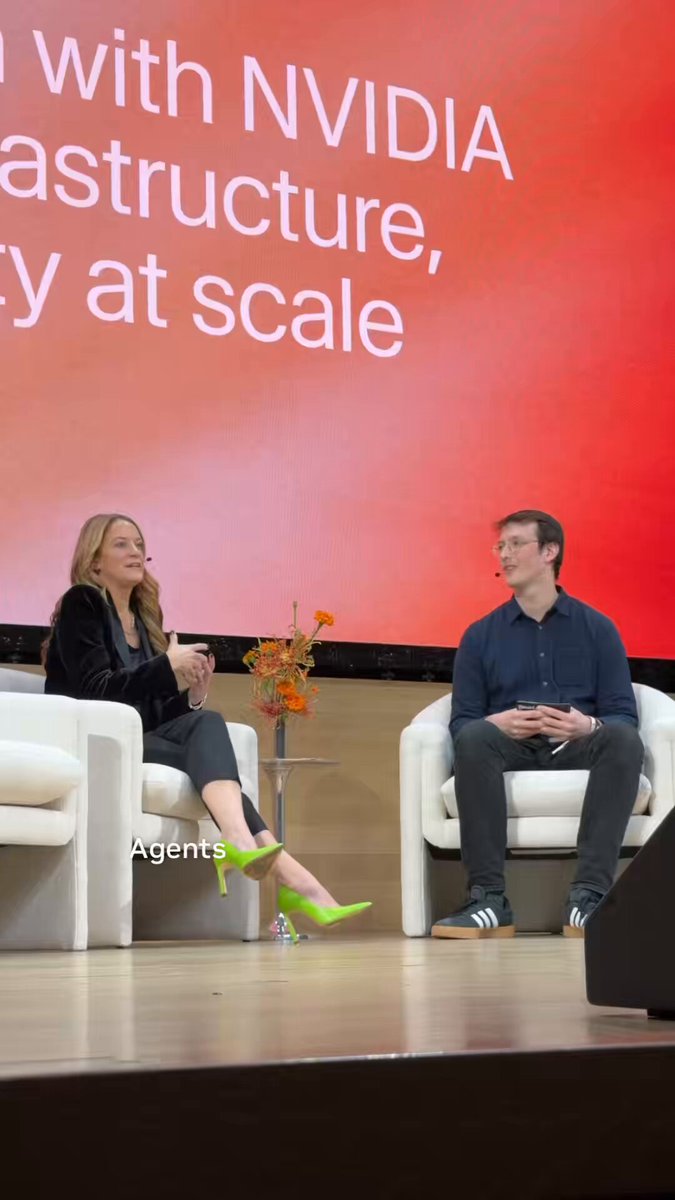
英伟达和 ElevenLabs 扩大合作,将 Nemotron 加入 ElevenAgents,为企业语音智能体提供更多模型选择。
Fish Audio Live 3 支持全双工语音
据 vLLM 项目介绍,Live 3 可以在输出语音时继续接收输入。vLLM 表示希望未来支持开放版本。
机器人从一次演示出发,在模拟器中排练
WICL 论文把模拟器反馈存入上下文,无需更新权重。作者报告在 RoboTwin 2.0 的 50 项任务中,干净与随机化设置平均成功率为 83.4%。
Sentence Transformers 6.3 面向向量压缩训练
新版支持在训练时就考虑 token 池化。维护者在一个 NanoBEIR 实验中把文档向量压到四分之一,保留未压缩分数的 97.8%,普通训练同口径为 94.6%。
Tree-Ising 尝试按位修复模型权重
论文把直接修改语言模型权重的问题转成稀疏离散优化,以选择需要改变的权重位。
社区拆出 47 个引理级强化学习任务
在 Hugging Face 发布数学强化学习环境后,社区贡献者将部分题目拆成 47 个更小的引理任务,供独立训练或评估。
开发者用 0.8B 模型处理 14,483 页 OCR
开发者报告用 LightOnOCR-3-0.8B 处理了一批行业文档,共 14,483 页。帖文是实际工作流分享,未提供跨模型准确率对比。
e-means 减少大规模向量聚类迭代
作者报告,在多种嵌入数据集上,e-means 用约 1.4–2.6 轮达到或优于 Lloyd k-means 跑 25 轮的目标函数值;具体收益取决于数据和实现。
Import AI 记录量子猜想的机器辅助证明
Import AI 报道,AI 科学公司 PSI 用内部模型得到 Aaronson–Ambainis 量子猜想的证明,并用 Lean 检查。该条为通讯转述。
Mistral 实时转录大会主舞台
Mistral 在 AI Engineer Paris 用 Voxtral Transcribe 3 转录演讲,把讲者姓名和术语作为上下文供模型参考。
Cerebras 演示 Kimi 的购物流程
Cerebras 用 Kimi K3.1 Pro 演示一次提示词驱动的购物流程,从查找显示器到结账。它是一次产品展示。
World Labs 演示单图生成可探索空间
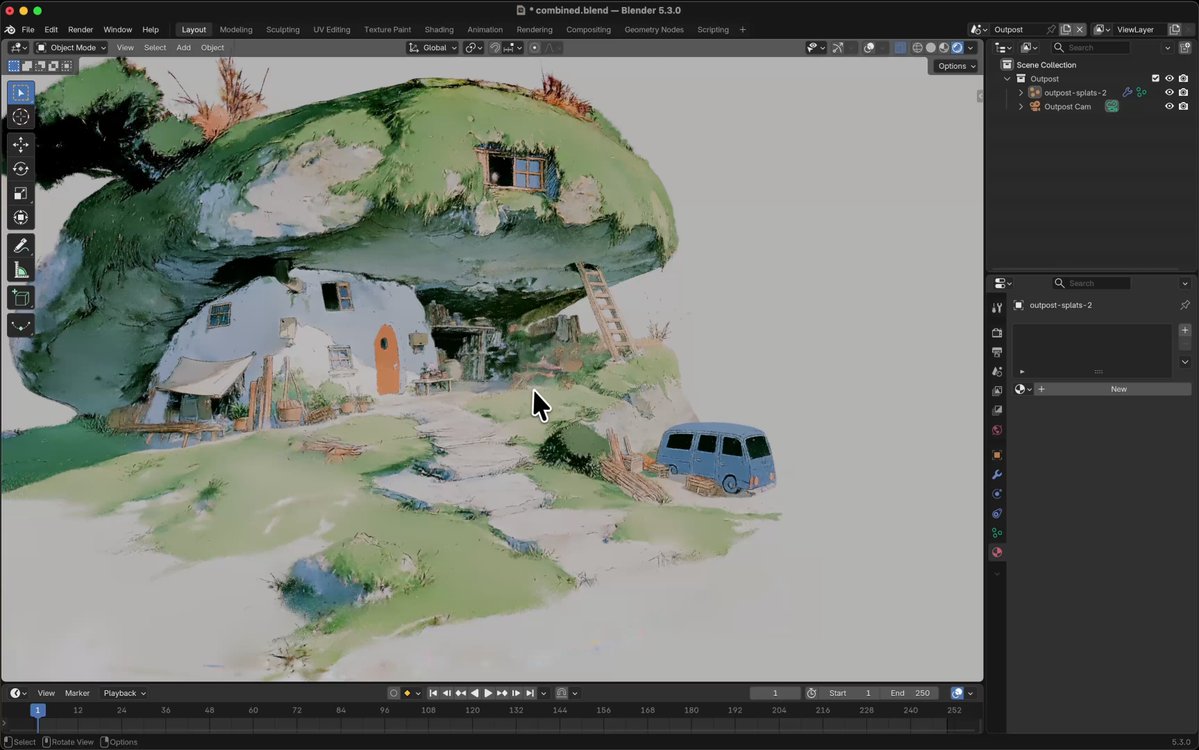
开发者分享了从一张静态图生成可移动视角的 3D 场景示例,使用高斯泼溅来表示补全后的空间。
Interior AI 演示从视频和户型图改造房间
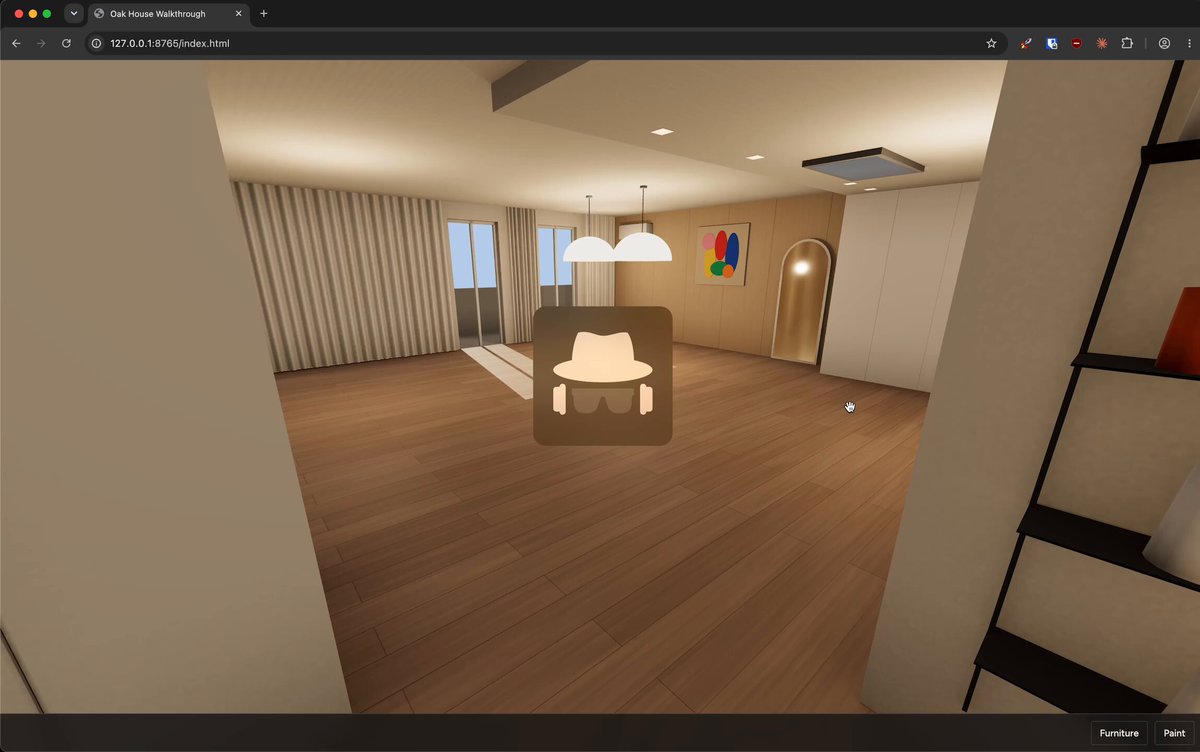
开发者展示上传视频、照片或户型图后,移除或挪动家具,以及调整墙面、地板和天花板颜色。
快速涂鸦展示 Gemini 的闭集判断
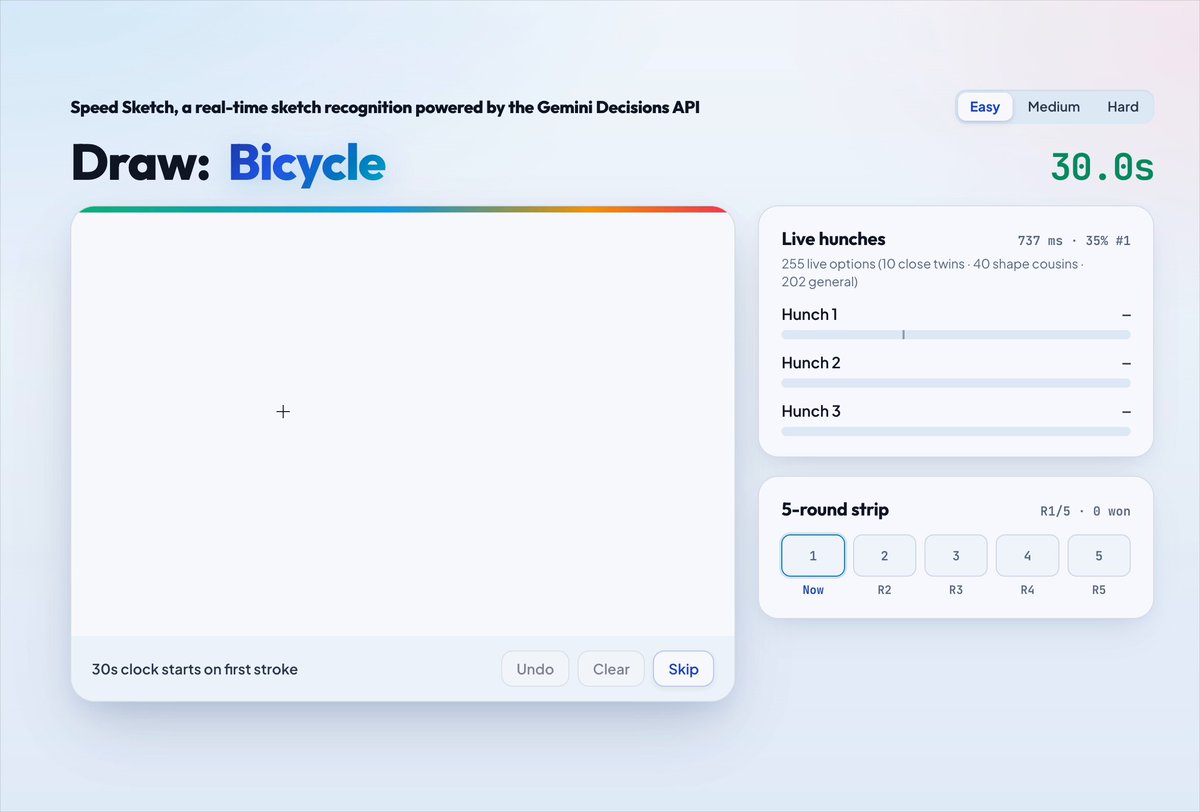
创作者用 AI Studio 制作猜画应用,让 Gemini Decision 1 根据涂鸦在预设名单中选出最可能的对象。
创作者用 Carbon 写出 SQL 光线追踪演示
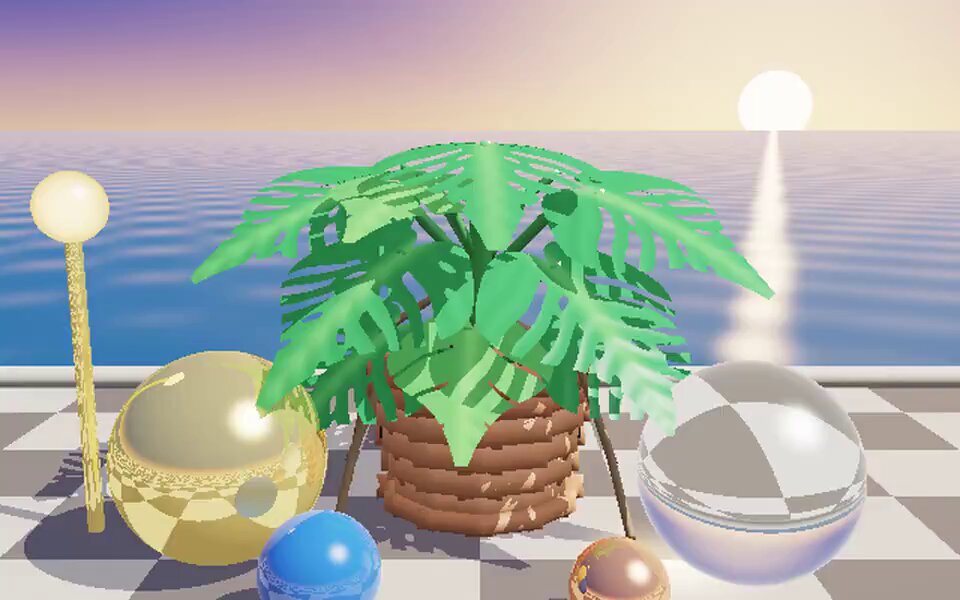
创作者展示了一个由 Gemini 4 Carbon 编写、以 SQL 实现的 3D 光线追踪实验。
创作者记录 Fable 5.2 的逐笔绘画
创作者称,模型在浏览器画笔工具里用约 94 分钟、11,066 笔完成一幅数字画,并为延时录像生成音乐。
智能体界面如何帮人验收
开发者以 Claude Artifacts 为例,提出智能体参与操作后,界面仍要帮助人定位改动、检查结果和继续调整。
让长任务尽早交付中间结果
创作者建议,给长时间运行的智能体设置阶段性交付,让人可以在任务中途调整方向。