研究前沿 · 数学
OpenAI 内部模型放出一批全新数学成果
团队称已就其中部分结果与数学界专家进行核对。
OpenAI 发布了一批由内部前沿模型产出的数学结果,并称已就其中部分成果与数学界专家进行核对。这批成果覆盖多个长期悬而未决的问题,团队没有公布模型细节,但强调这是模型在纯推理领域一次系统性的突破。对研究者而言,真正的难题正从「能否解出」转向「如何验证」——当模型一夜之间给出大量命题的证明,人类需要更快的机器辅助审阅,才能分辨哪些是真正的进展,哪些只是漂亮的幻觉。
工具 · 溯源
SynthID Detector 面向所有人开放
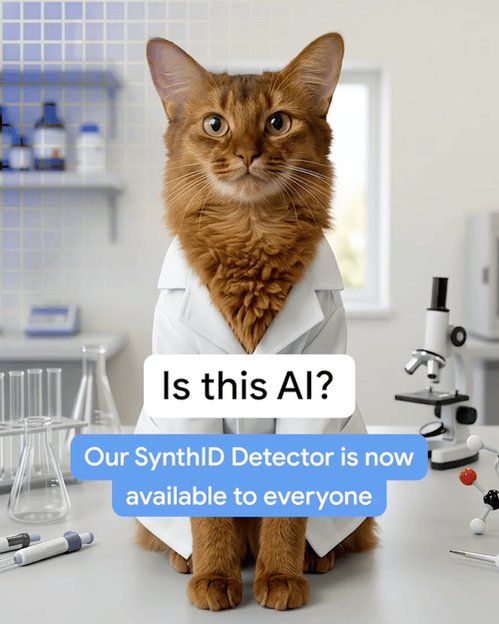
Google DeepMind 宣布 SynthID Detector 面向所有人开放。用户现在可以检测线上内容是否由 Google AI 生成,或由 OpenAI、NVIDIA、Kakao 等合作伙伴的工具产出,苹果的支持也即将到来。
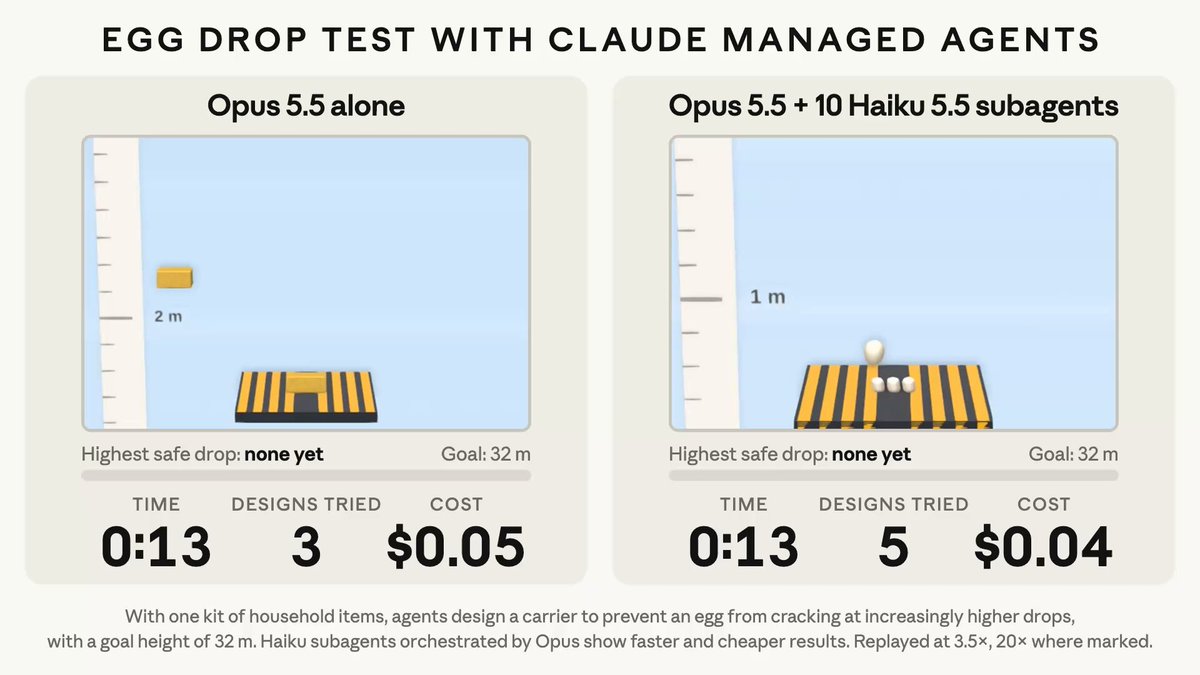
「很快,所有软件都将事实上开源。」
@amasad · 关于 AI 驱动的逆向工程与反编译
Perplexity · Embeddings
pplx-embed-v2-late 开源:共享向量空间的多模态检索
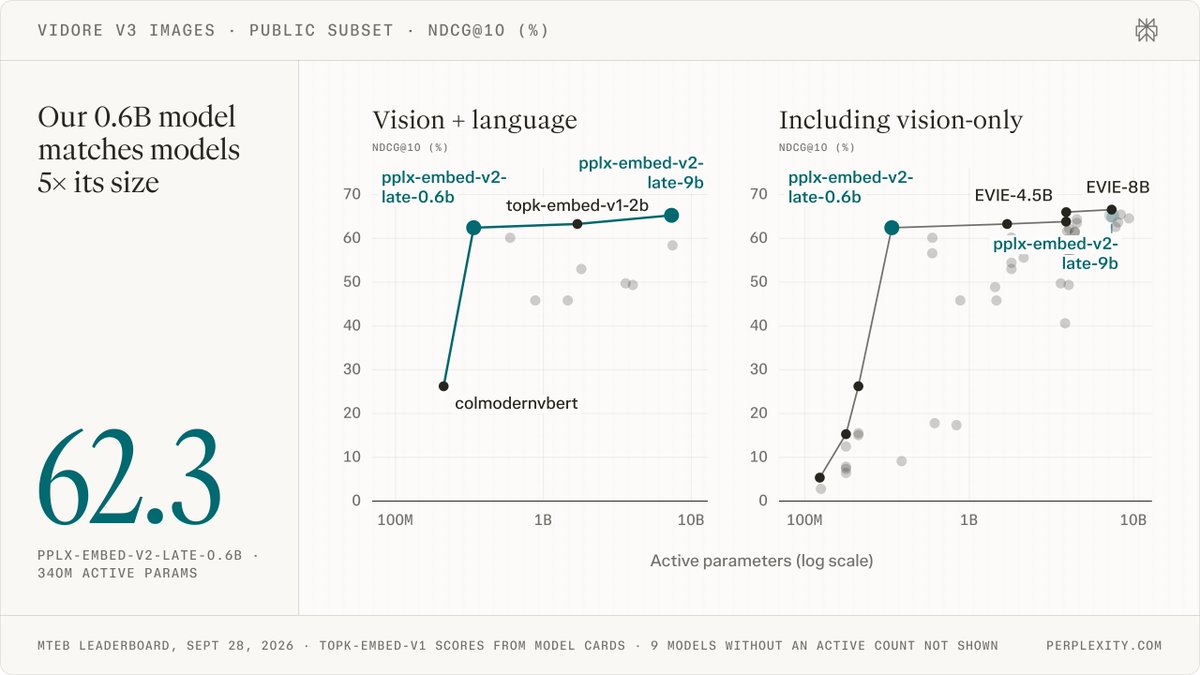
两个晚期交互嵌入模型,用同一个嵌入空间检索文本、图像与页面,支持跨模型查询,已公开在 Hugging Face。
Kling · 电影
Kling 4.0 即将发布,走进釜山 ACFM
十月,全球电影人将齐聚釜山,Kling 4.0 发布在即,团队将带去一系列用该模型完成的真实项目,探讨 AI 如何理解导演的创作意图。
vLLM · 路由
Vela 2.0 一次调用完成多项路由决策
在跨度级别处理安全检查、领域分类、PII 识别与不支持声明检测,提供 0.3B 到 9B 四种规模,Apache-2.0 许可。
vLLM · 推理
DeepSeek-V4.1-Flash 三周内吞吐提升 5.3 倍
低并发下速度提升 1.9 倍,在 AgentX 上每用户 150 TPS 时吞吐提升 5.3 倍,主要涉及 SWA 边界处理。
Google · 多模态
EmbeddingGemma 2 在手机上本地检索照片视频
文字、图片、视频、音频与代码放进同一套坐标系,无需联网即可用一句话找到一段视频。
Liquid AI · 开源
Open d1 发布两款开源多模态决策模型
d1-3B 负责高质量文本与视觉决策,实验性的 d1-omni-600M 面向对体积敏感的场景。