@GoogleDeepMind
DeepMind 称 AI 发现旧式 RSA 弱点
人类指导的智能体参与传统加密系统压力测试。
Google DeepMind 披露,在人类指导下,模型参与加密系统压力测试,发现传统 1024 位 RSA 系统的两处重大弱点。公告讨论的是特定旧式系统,不能据此推断所有 RSA 配置或现代加密系统均已被攻破。
@AnthropicAI
Anthropic 拆解智能体记忆组件
工程博客指出,Claude 必须在尚不知道后续情况时决定哪些信息值得记住。“dreaming”用于整理已经学到的内容、修正错误,让下一次检索更容易;这里描述的是记忆组织机制。
@johnschulman2
Inkling 2 Small 发布,团队详述对齐经验
John Schulman 宣布 Thinking Machines 新模型 Inkling 2 Small,介绍训练过程的博客也重点讨论安全与对齐。相较一句榜单分数,团队如何理解和约束模型行为同样值得关注。
@soumithchintala · 转引 @arcprize
ARC Prize 公布 Inkling 2 Small 评测
Soumith Chintala 转引 ARC Prize 的已验证结果:ARC-AGI-2 为 81.7%,每任务成本 0.27 美元;ARC-AGI-1 为 96.5%,每任务 0.08 美元。这些数字对应所述基准与测试设置。
@OpenAI
BioBasicsBench 测试实验室日常分析
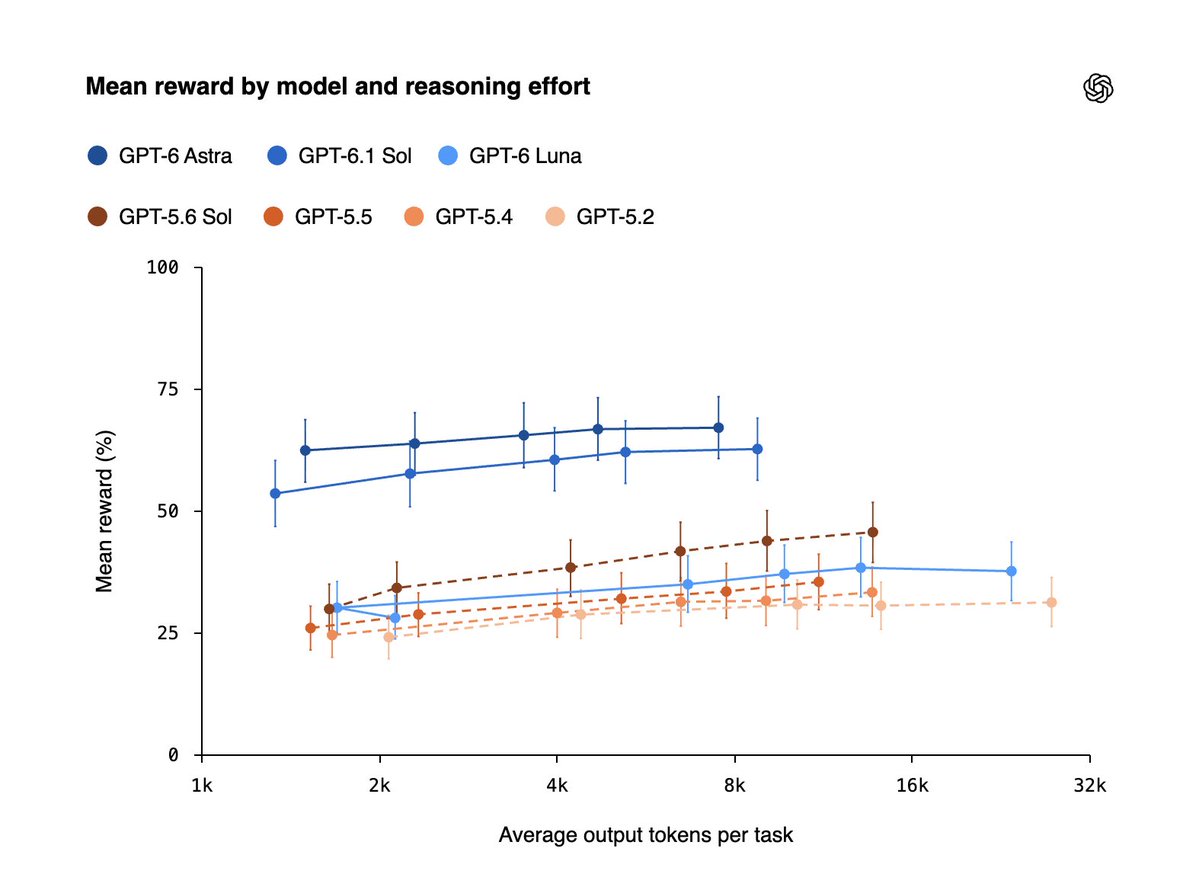
OpenAI 与酶设计公司 Ligo 合作构建 BioBasicsBench,采用来自真实实验的 100 个任务,测试智能体解读原始实验数据等常规分析能力。现有公告未提供可据此引用的完整模型成绩。
@ClaudeDevs
Claude Code 云会话可保存仓库环境
Claude 开发者团队称,Pro、Max 和 Ultra 用户的云会话可识别所需依赖、网络访问和 API 密钥,并保存环境供下次使用。团队表示密钥安全保存,Claude 不会看到密钥内容。
Meta 将 Muse Wonder 专用模型接入产品
Meta 宣布把使用 Muse Wonder 训练的专用模型带入 Muse 与 Meta AI,并提到 Active Memory。原帖在其他能力名称处被截断,不据此补写完整功能清单。
MiniMax M3.1 Flash 上线 Fireworks
MiniMax 宣布 M3.1 Flash 已在 Fireworks AI 提供服务,并预告双方将在旧金山活动中讨论构建过程。公告未给出新的性能对比数据。
Voxtral 3 识别用户何时说完话
Mistral 介绍 Voxtral 3 的话轮结束检测,用于判断用户是否已经说完,帮助开发者构建响应更及时的语音交互。
混元称登顶 APEX-Agents 开放权重榜
腾讯混元账号公布 APEX-Agents 开放权重模型第一的排名信息。原帖非常简短,没有附上可供本文比较的测试配置和完整成绩。
社区开源 Qwen Concept 27B
Hugging Face 联合创始人转引开发者消息:Qwen Concept 27B 通过直接权重空间编辑构建,灵感来自近期相关研究。这是社区项目,不能从模型名称推断它是 Qwen 官方发布。
Inkling 2 Small 获 DesignArena 开放权重第一
Soumith Chintala 转引 DesignArena 消息,称 Inkling 2 Small 当时位列总榜第四、开放权重模型第一。排名只对应该榜单及当时状态。
Thinking Machines 强调模型可定制性
Soumith Chintala 表示,团队花了很多时间研究如何让模型适合定制,并认为 Inkling 2 Small 在固定数据和预算下具有竞争力;这是团队对训练与定制方向的说明。
小模型安全测试覆盖训练过程与防护规避
Thinking Machines 团队介绍,训练期间进行主动安全监控,并结合内部与外部测试研究模型尝试绕过防护的行为,以及相应约束措施。
团队称新模型预训练不到三天
Soumith Chintala 转引基础设施团队介绍,Inkling 2 Small 的预训练耗时略低于三天。这一口径仅指预训练,不等于整个研发与后训练周期。
OpenDesign 比较 Hy4 的设计分数与成本
姚顺雨转引 OpenDesign 的测试:Hy4 比 GPT-6.1 Sol 低 0.1 分,估计成本低 41%。该成本和分差属于特定设计基准,不能直接推广到全部任务。
Nace AI 推出 Drex 多模态决策模型
研究者介绍开源 Drex 模型家族及技术报告,称 Drex Max 在 Decision Bench v4 与 GPT-6 Sol 持平,并在 DecideBench 获得较高准确率。现有帖子未展示完整配置,结果保留来源归因。
North 2 支持复用并共享智能体与技能
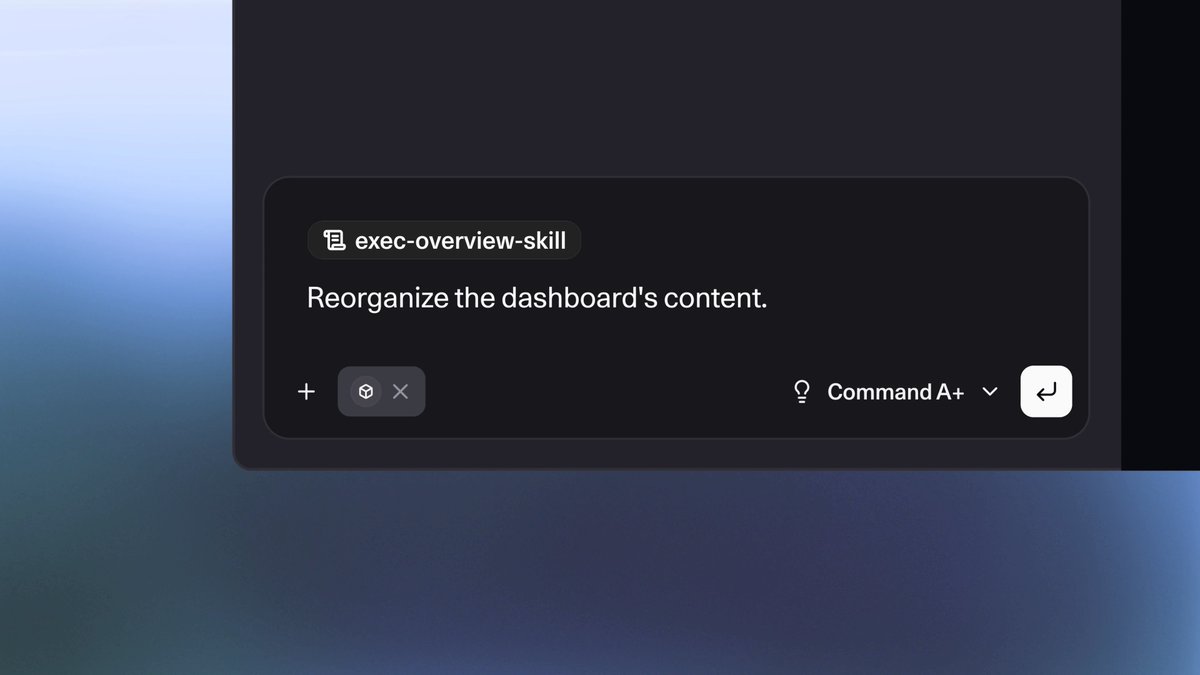
Cohere 介绍升级后的 North 2,强调可复用的智能体和技能;个人创建的能力也可与团队共享,用于减少重复事务。
OpenDirector 提供本地短片创作工作台
项目资料介绍,ThinkFlowLab 的 OpenDirector 由 vLLM-Omni 驱动,可调用多种模型,把短片生成、编辑和导出放在本地工作流中。
Harness Leaderboard 比较模型运行框架
Clement Delangue 转引 Joel Niklaus 发布的 Harness Leaderboard,用于帮助开发者选择运行模型的 harness。帖子没有提供可在本文引用的完整排名。
研究者尝试用适配器改善 harness 配合
Lysandre 的团队分享 harness adapters 方向,希望改善模型与运行框架的配合。现有短帖只给出了方向,不据此推断通用兼容性已经解决。
CRUX-in-a-box 面向数周级智能体评测
Arvind Narayanan 转引开源项目 CRUX-in-a-box,可运行和监控持续数周的智能体评测。长周期运行基础设施与模型在评测中的实际表现是两件事。
Replit 与 Plaid 连接金融账户
Replit 介绍与 Plaid 的集成:连接个人或企业金融账户后,用户可围绕自己的财务需求构建工具。公告将其定位为无需编码的构建流程。
Replit 创始人介绍定制内核防护
Amjad Masad 称,Replit 的定制内核构建可避开 96% 的 Linux 零日漏洞,并指向新沙盒设计。该百分比为厂商说法,原帖未列出统计样本与评估口径。
Hugging Face 可直播训练运行
Hugging Face 宣布支持直播展示训练运行。短帖没有给出更多配置细节,适合关注希望公开训练过程的团队。
DSPy GEPA 从历史 Slack 数据优化提示词
Omar Khattab 转引实践分享,团队用历史 Slack 数据和 DSPy GEPA 训练提示词,强调生成内容对具体团队语境的贴合。这是一个实践观察。
Perplexity 展示持续制作游戏模组的 Teammate
Arav Srinivas 介绍 GTABot,其任务是持续创建 GTA 模组,并展示依据社区地图、按每米一个方块重建区域的 Minecraft 模组案例。
Runway 接入 GPT Image 2.6
Runway 宣布上线 GPT Image 2.6,称图像生成更快,支持 GIF、SVG 导出,以及保持角色、产品和品牌细节的一致性编辑。性能描述来自产品公告。
GPT-Image-2.6 可用于个人与团队 GIF 创作
OpenAI 开发者账号展示 GPT-Image-2.6 的 GIF 创作能力,强调个人和团队都可使用;该帖没有披露新的价格或使用额度。
Higgsfield Miracle 预览重着色与文字编辑
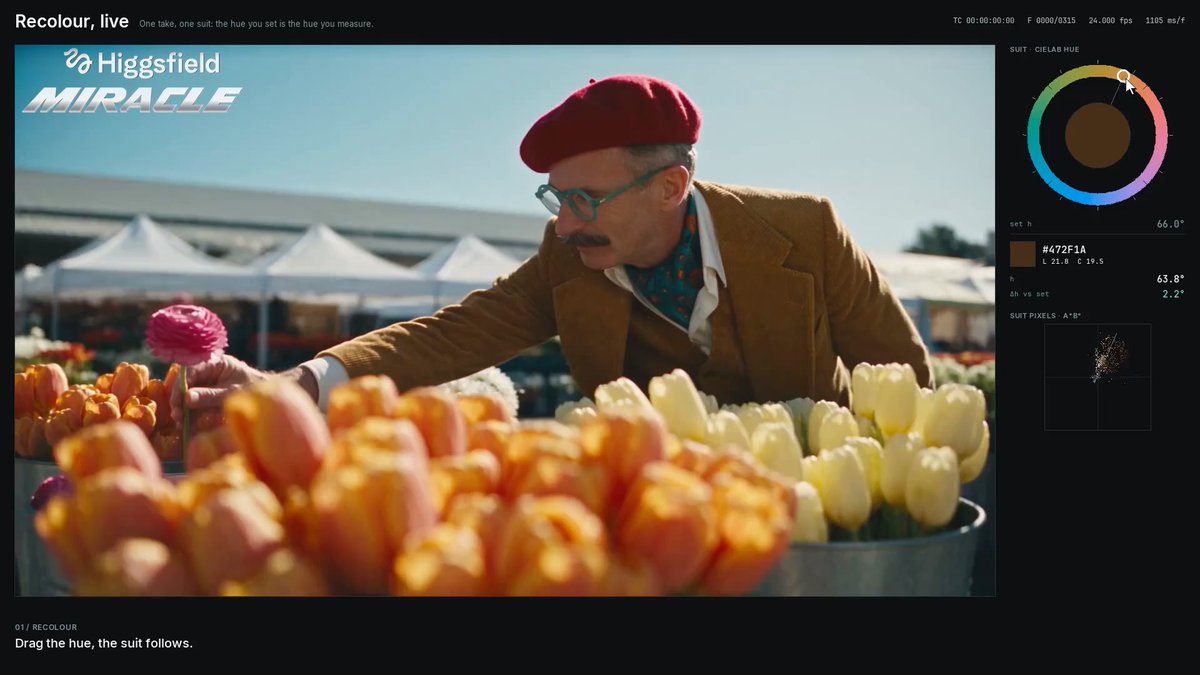
Higgsfield 展示 Miracle 的对象重着色、实时文字编辑等能力,并称将接入 Higgsfield MCP。“零帧编辑延迟”为演示宣传口径,产品仍是即将推出状态。
Higgsfield 展示 Claude 自动制作纪录片
厂商称,Claude 配合 Higgsfield MCP 自动完成脚本、镜头、旁白、音乐、音效与剪辑,生成十分钟恐龙纪录片。“广播级”质量属于厂商对演示的描述。
Recraft Vary 区分构图变化与细节变化
Recraft Studio 上线 Vary:选择图像后,可用 Vary direction 探索新构图,或用 Vary details 只调整小细节,无需再写提示词。
Recraft 回顾 Logo 与视觉标注更新
Recraft Studio 的十月回顾还提到 Logo Maker、Visual Annotations,以及六个图像和视频模型。回顾内容不应被理解成当天同时发布的新功能。
Seedance 2.5 已接入 Adobe Firefly
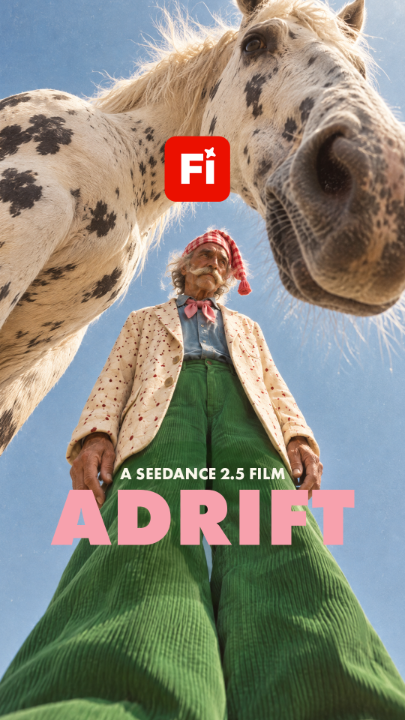
Adobe 官方帖宣布 Seedance 2.5 进入 Firefly 并邀请免费试用。目标页面只返回需要 JavaScript 的提示,未能据此核实具体价格、额度或上线范围。
Kling 4.0 原创短片展示赛车场景
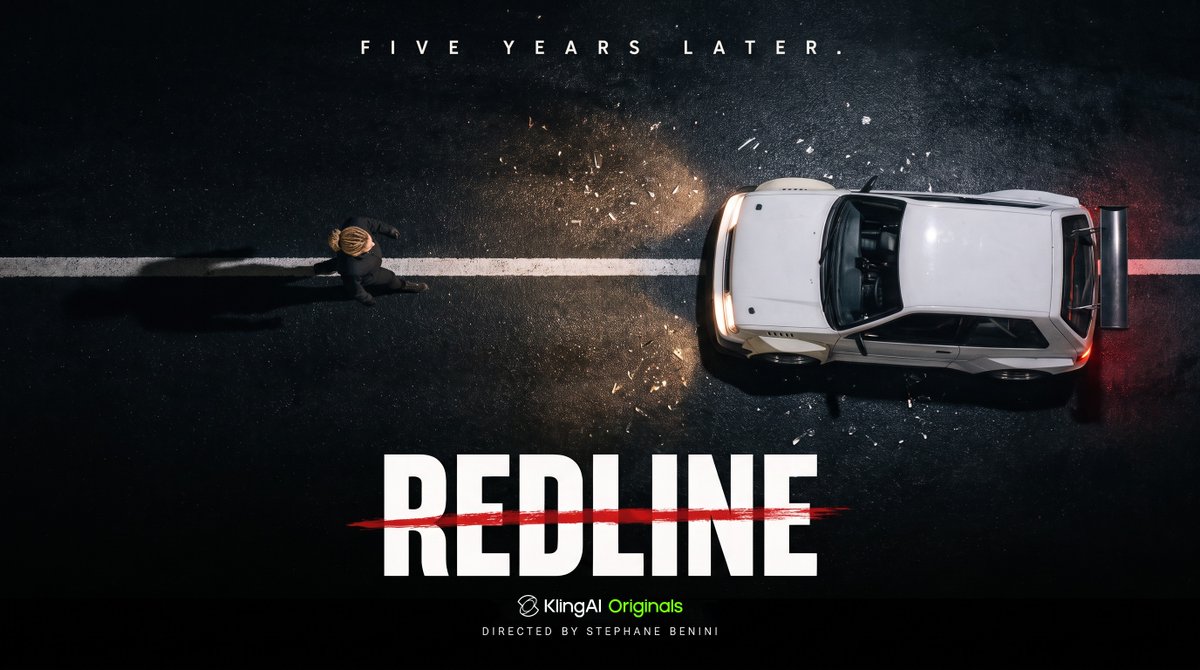
Kling AI 发布由 Kling 4.0 驱动的原创短片 Redline,以赛车场景展示高速运动和镜头表现;这是创作演示,不是标准化性能评测。
Vidu Q4 Preview 展示云朵主题视频
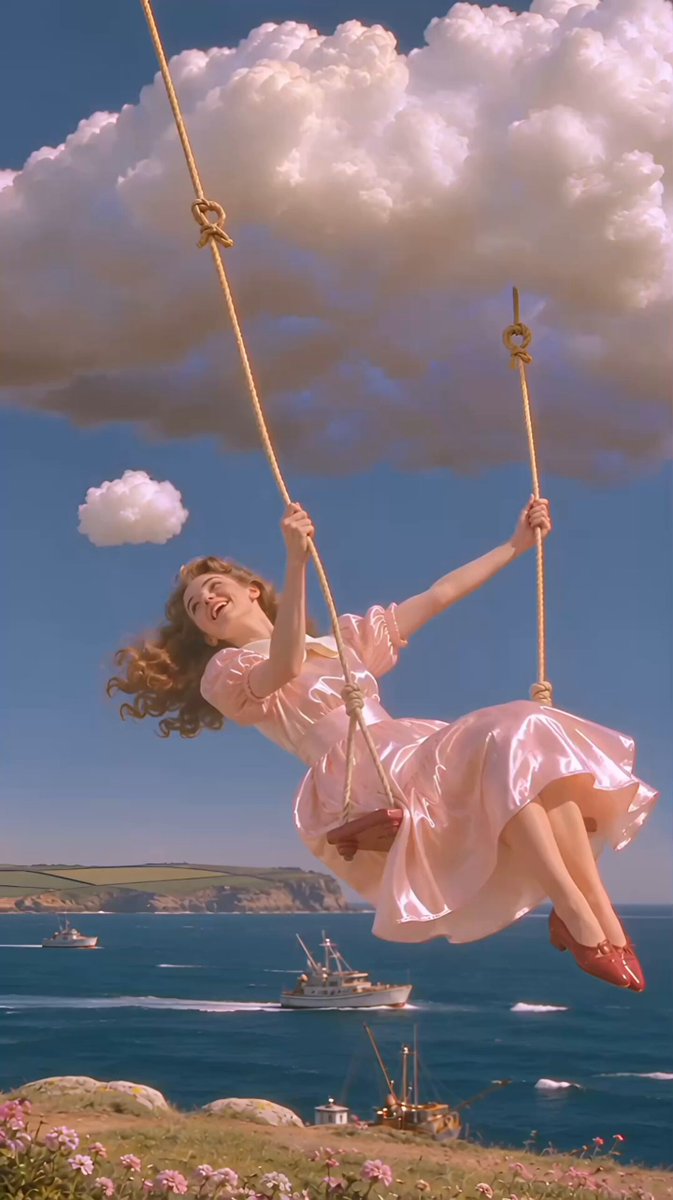
Vidu 用 Taste of the Clouds 展示 Q4 Preview,并在原帖给出体验邀请码。该案例展示的是预览模型的视觉创作能力。
PixVerse Canvas 提供 GPT Image 2.5
PixVerse 宣布 Canvas 接入 GPT Image 2.5,用于广告创意、造型册和故事板,并介绍服装、道具、背景的编辑及角色一致性。
Gemini Omni Flash 1.2 支持十五秒视频
Martin Nebelong 转引产品负责人消息:Gemini Omni Flash 1.2 开始推出,支持最长十五秒的视频生成,并加强电影化控制。现有转帖正文被截断,不据此补写完整能力清单。
Anthropic 讨论 AI 如何改变科学建模
Anthropic 科学博客讨论 AI 对科学建模的影响,包括解释和预测单神经元放电等真实系统。现有公告属于研究方向介绍,不包含可引用的完整实验结果。
CulturalRiddles 用文化谜题测试模型
Cohere Labs 通过人工编写的文化谜题评估 28 个 AI 模型,并报告文化理解上的明显缺口。现有转帖未展示各模型完整成绩。
Muir 按敏感性分配线性注意力门控
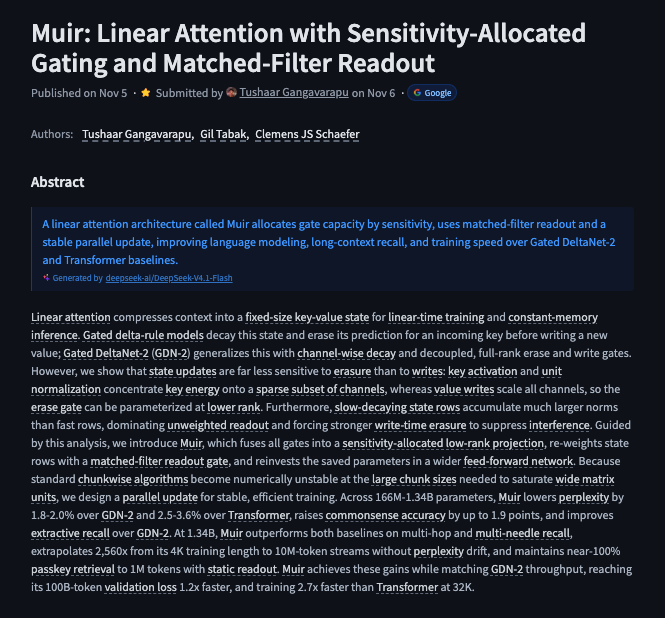
论文提出低秩门控投影、状态行重加权与匹配滤波读出,把节省的参数用于加宽前馈网络。作者在 166M 至 1.34B 参数规模上报告了相对 GDN-2 和 Transformer 的困惑度改善。
有道 R2T2 让流式转写保留稳定前缀
Confucius4-R2T2 在 1500 小时中英文音频上后训练 Qwen3-ASR-1.7B,通过最长稳定前缀机制避免改写已输出的早期文本。论文称其兼顾低延迟与识别质量,权重和代码已开源。
TailSteer 在去噪轨迹尾部抑制编辑漂移
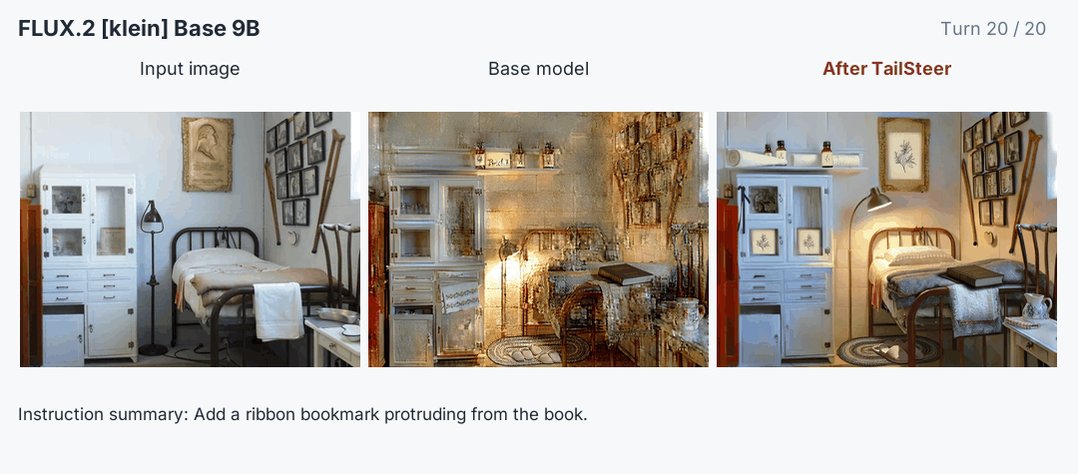
该训练框架让早期去噪贴近基座,只在轨迹尾部学习保真校正,无需人工标注编辑对。论文在 FLUX、SenseNova、Qwen 系列的十五至二十轮编辑实验中报告累积漂移降低。
OPAL 让语言模型在训练中改写优化器
Reactive Optimizers 介绍 OPAL:智能体检查单次训练动态,改写可执行优化器代码,可调整参数组规则、调度和精度。作者报告其在所选未调优任务上匹配或超过固定配方,并讨论额外计算成本。
大模型指导小型检索器持续强化学习
Omar Khattab 转引技术解读,介绍由大模型持续指导一个 0.4B 参数检索器强化学习的思路。现有转帖在对比对象处截断,本文不补写“超过所有大模型”等结论。
研究者关注 Full Bandwidth Transformer
Arohan 引述字节实验,认为 Full Bandwidth Transformer 的某个变体可能接近两倍规模模型的表现。这是针对特定实验的观察,不是所有配置均可节省一半算力的结论。
字节 Seed 发布液态修正数据集
研究动态介绍 Hugging Face 上的 MLIP-liquid-corrections 数据集,提供 BSSE 与 ATM 修正标注。原帖在细节处截断,不额外推断数据规模或适用精度。
LeRobot v0.7.0 发布
LeRobot 宣布 v0.7.0 上线,并提到从 TB 级数据处理到提示机器人等工作流。原转帖没有完整更新日志,本文不补列未见到的功能。
Möbius 连接人体动作理解与生成
研究者介绍统一的动作与语言模型 Möbius,目标是连接人体动作理解和生成。现有转帖未提供完整任务与基准结果。
社区介绍 Liber-0 的机器人测试
Linus Ekenstam 称,Liber-0 在未针对这批任务采集机器人演示训练的条件下接受 60 个任务、600 次试验,总成功率 36%,拾取放置为 63.5%、其他操作为 34%。这属于其转述的实验结果。
RGBMocap 实践将视频转为动作素材
创作者分享用 RGBMocap 从视频提取动作,并提到本地 MiniMax H3 和角色替换 LoRA 的组合。这是具体工作流分享,不代表不同输入都能获得同等质量。
OpenAI 与行业机构提出网络危害评估框架
OpenAI 与 Frontier Model Forum 及成员机构合作,试图识别绕过 AI 安全措施何时可能造成严重网络危害,并优先加强相应防护。
SGLang 披露两种并发条件下的吞吐
SGLang 称,在 GB300 NVL72 上,低并发可达每用户每秒 420 多个 token,高并发可达每 GPU 每秒 3.1 万多个 token。两项数字来自不同负载条件,不能当作同一运行点的性能。
Inferact 称日服务量超过七万亿 token
Woosuk Kwon 转引 Inferact 公告,称其平台每天服务超过七万亿 token。该数字是平台披露的流量,不是本文独立审计的统计。
vLLM 在 TPU v7x 支持 Kimi K3.1 Pro
Inferact 宣布与 Google 合作,在 TPU v7x 上为 vLLM 提供 Kimi K3.1 Pro 首日支持。现有转帖未给出吞吐或成本对比。
NanoDC 介绍太阳能自主推理数据中心
CoffeeVectors 转引 LiquidEnergy 的项目介绍,称 NanoDC 是面向 AI 推理的太阳能自主数据中心。帖子缺少可验证的容量、成本和持续运行数据。
二手解读称企业 token 支出增速放缓
宝玉转述 Ramp 数据:企业 token 支出七月环比增 42%,八月增 1%,九月增 0.2%。这些是所述样本的支出变化,不是 token 使用量变化;原始统计与估值传闻未在本条素材中独立核实。
Jeff Dean 等支持开放科学研究资助
Jeff Dean 宣布与 Laude Institute 以及多位计算机科学家合作,为开放科学的探索性项目提供资金支持。原帖没有给出资助总额。
Longevity Grok 提供个人研究资料整理
项目页面将 Longevity Grok 定位为运行在 Grok Bot 上的个人长寿研究团队,提供健康记录、研究简报和就诊准备。诊所版和实验室版需要申请早期访问。
从直接操作,走向监督与解释工作
Runway 联合创始人 @c_valenzuelab 观察到,界面正从直接制作东西的入口,转向监督智能体、解释其工作结果的入口。
Arav 认为 git 可成为智能体协作记录
Perplexity CEO 认为,智能体将越来越多地调用其他智能体;让执行代码和运行轨迹进入版本控制,有利于围绕 git 形成可持续积累的协作记录。这是其架构判断。
Perplexity 披露内部智能体使用变化
Arav 称,相比九月,员工每周获得的智能体工时中位数已增至七倍,五分之一员工每周获得 40 小时以上。智能体运行时间并不直接等于人的有效工作时间或产出增幅。
代码能生成,仍要判断哪些优化值得做
Vercel CEO 认同“编码已解决,但 bug 没有”的表述,并指出可以持续消耗 token 进行改进,甚至优化无人关心的问题。重点落在判断价值与发现问题上。
社区质疑文件式记忆的学习上限
Teortaxes 认为,用更强模型整理更多 Markdown 文件虽有成效,能力上限仍受预训练影响。这是对智能体记忆机制的评论,并非已证实的能力边界。
硬件速度比较需要先说明运行目标
Teortaxes 引用 Vera Rubin 与 GB300 在每智能体每秒 260 和 80 token 时分别为 5.0 倍、1.7 倍的吞吐比较,讨论交互速度与最大吞吐的区别。原始测量配置未在该帖完整给出,这些数值保留待核实属性。
宝玉把功能截图带进智能体 PR 审查
宝玉分享,要求提交 PR 时附上相关功能截图,能促使提交者至少实际运行一次;他正把同样做法用于 AI 智能体。该帖属于团队工作方法分享。
Mollick 讨论金融波动与 AI 采用的区别
Ethan Mollick 认为,AI 股票潜在回调不会自动改变企业采用和技术开发的轨迹。这是其对行业演进的判断,不是对市场走势的预测依据。
创作者分享十七个 Grok Bot 助手的分工
一名创作者列举自己的 Grok Bot 助手,分别用于动画系列、书籍、日语和工作等。该例展示个人任务拆分方式,未提供独立的效率评测。
循环智能体的规格可以成为内部细节
宝玉转引工程实践观点:让 spec 和 task 成为 Loop Agent 的内部细节,人类则保留离散、粗略的输入。这是关于人与智能体分工的设计主张。
开源机器人让后续工作可以接续
Clement Delangue 强调,开源能让学生、研究者和创业者基于多年积累继续构建,并贡献回社区,而非把机器人能力集中于少数黑盒系统。
插件维护也包括自动更新机制
宝玉分享,为 DeepSeek Harness 编写插件时,还需要自行实现插件自动更新。这是一条工具维护过程中的实际观察。
Latent Space 介绍 Reducto PDF 工作流
Latent Space 预告一期以烹饪秀形式讲解 Reducto AI 的 PDF 处理流程的内容。抓取页面只有频道介绍,因此不延伸总结未读取的视频技术细节。
Weta FX 高管谈影视行业 AI 战略
CoffeeVectors 转引 Variety 对 Weta FX 负责人的报道,称影视行业对生成式 AI 的态度正变化,并强调 AI 战略。这里保留报道归因,不把观点当作行业已完成转型的事实。