@Kimi_Moonshot
Kimi K3.1 Pro 开放权重
月之暗面在 Hugging Face 发布 Kimi K3.1 Pro 权重。模型卡将其定位为 3T 级、原生多模态的智能体模型,支持百万 token 上下文,由 Kimi K3 经大规模联合强化学习后训练而来。官方称其改进编码、3D 创作、金融研究等任务,API 兼容 OpenAI 与 Anthropic 接口。
@OpenAI
Images 2.6 加入 GIF 与参考图
OpenAI 发布 ChatGPT Images 2.6,新增 GIF 和参考图支持,并宣布两个 API 图像模型,称图像生成速度较此前提升 50%。ChatGPT 功能与 API 模型的接入范围应分别看待。
@OpenAI
OpenAI 报告验证 948 个内核提权漏洞
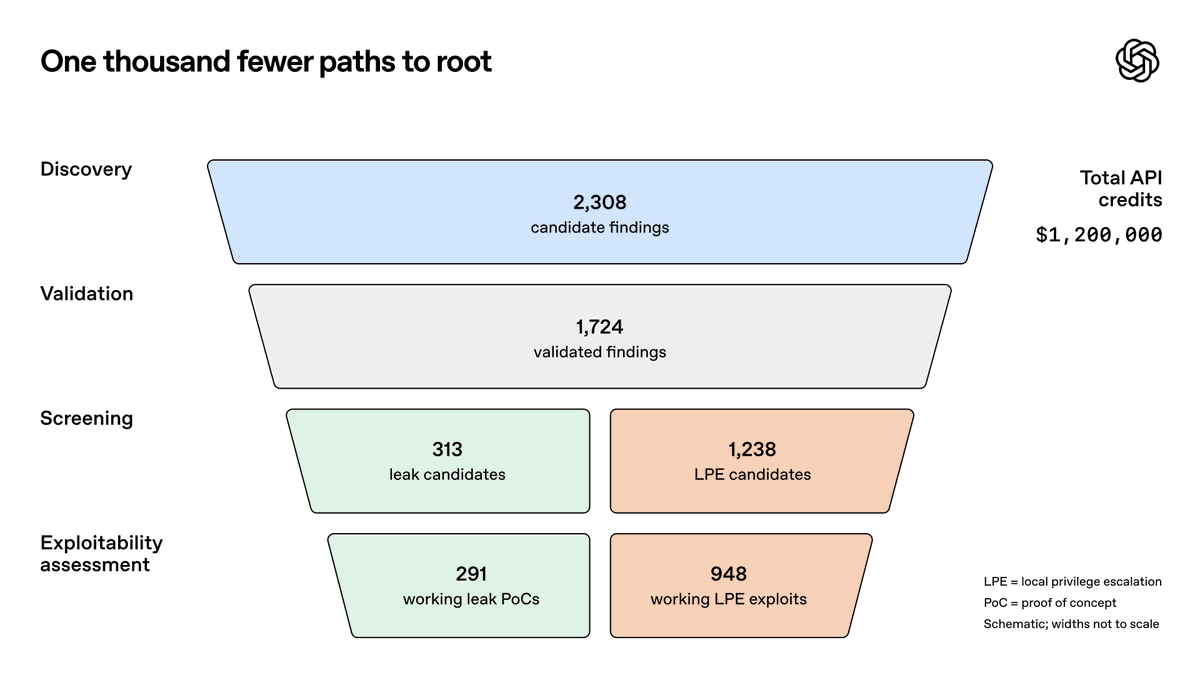
OpenAI 称,安全团队构建了自主发现、利用验证与修补管线;使用一款尚未推出的网络安全模型,单次运行验证并生成了 948 个 Linux 内核本地提权漏洞的补丁。这是发布方自报结果,不表示补丁均已被内核维护者接受或部署。
@TencentHunyuan
腾讯混元发布新模型 Hy4
腾讯混元发布 Hy4,并转发早期体验与评测反馈。官方发布短帖仅作模型介绍;权重是否开放、榜单名次及测试条件需要与后续具体公告区分。
Image-2.6 进入 Codex 与 API
OpenAI 开发者团队宣布将 GPT-Image-2.6 带入 Codex 与 API。Flare、Sunburst 两款 API 模型据称提速 50%;Sunburst 在中、高质量设置下更能保持连续编辑的细节一致性。
vLLM 首日支持 Kimi K3.1 Pro
vLLM 宣布首日支持 Kimi K3.1 Pro,面向百万 token 长上下文任务。公告援引的 Terminal-Bench 4.0 成绩为 65.7%,使用 Claude Code harness;模型评测成绩不等于 vLLM 服务吞吐。
SGLang 展示稀疏注意力服务结果
SGLang 称 Kimi K3.1 Pro 将稠密 MLA 换为稀疏注意力 DSA。其首日服务数据包括 AgentX、GB300 条件下每 GPU 最高 33.7K tok/s,以及配合 DFlash2、MegaKernel 的单用户 450 tok/s;两项结果对应不同测试条件。
Kimi K3.1 Pro 上线 Ollama Cloud
Ollama 宣布 Kimi K3.1 Pro 已可在 Cloud 使用,称模型总参数 2.8T、激活参数 104B,面向编码、3D 创作和研究任务;服务方表示美国托管并实行零数据保留。这不等同于本地设备已能运行同等规模模型。
Kimi K3.1 Pro 登陆 Nebius
据 @Kimi_Moonshot 发布:Nebius Token Factory 首日上线月之暗面开放权重模型,主打编码性能。
Agent Arena 转推称 Hy4 位列第 14
腾讯混元转引 Agent Arena 消息,称 Hy4 在当时综合榜单排名第 14,且当时仍是专有模型。原帖在后续权重说明处截断,不能据此确认开放日期。
Ripple-65B Preview 发布
Jeff Dean 转发 Ricursive AI 的发布消息:Ripple-65B Preview 是从零预训练的 65B 稠密语言模型。发布方声称取得新的领先结果,但原始短帖截断,不能从该条确定完整榜单、测试范围或比较条件。
Cognition 新模型的基础模型归属
Soumith Chintala 表示,Cognition 的新 Flash 模型是在 Inkling-small 上进行后训练。该条聚焦模型来源,并未声称 Cognition 自行完成基础预训练。
Ripple 的 3200 万美元是完整研发口径
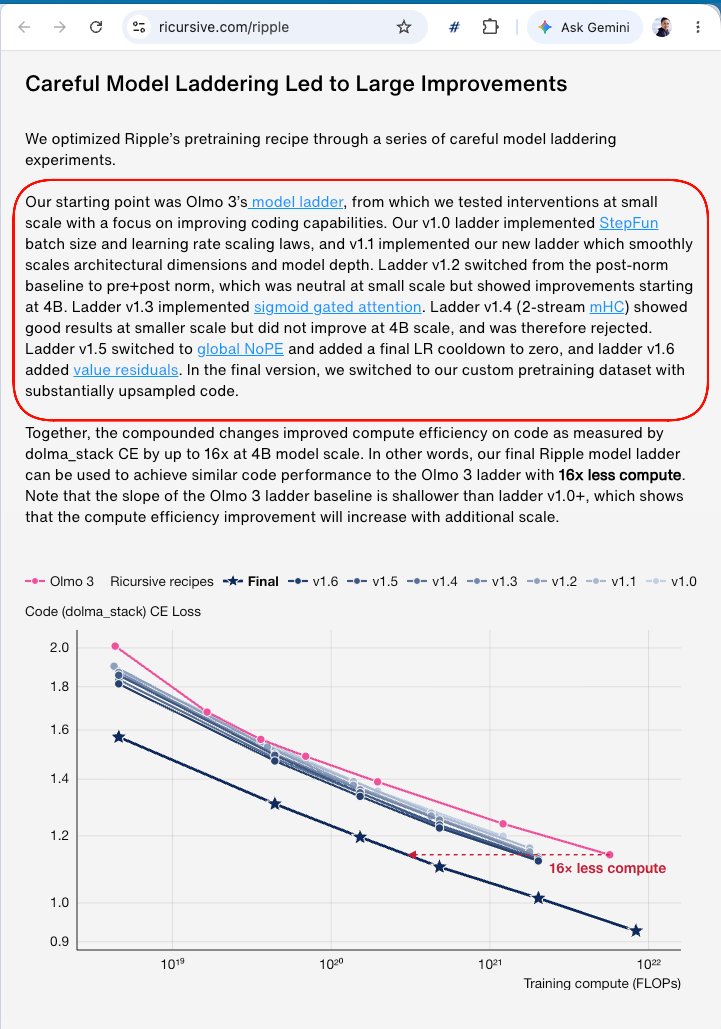
swyx 引述 Ripple-65B Preview 团队称,从零开发与训练的完整研发成本为 3200 万美元,包含预训练阶梯实验,而非仅最终训练一次的算力账单。其与其他模型的成本比较仍是团队口径。
Ripple 成本与性能比较受到质疑
teortaxesTex 对 Ripple 的 65B 稠密规模、效率和 3200 万美元成本宣传提出疑问,并质疑其与 V4 Flash 的性能比较。该条是个人评论;应与完整研发成本说明及具体基准一起看待,不把疑问当作已证实的反例。
Gemini 3.8 Flash TTS 上线语音混音
据 @GoogleDeepMind 发布:Google AI Studio 与 Gemini API 新增 Voice Remixing,可从预设声音开始定制。
Cohere Embed 5 与 Rerank 5 上线 OpenRouter
据 @cohere 发布:检索模型通过单一 API 提供 Pro/Fast 两档,统一账单,降低切换成本。
Axion 1.0 发布完整开放训练配方
据 @_lewtun 发布:35B 开放智能体基础模型提供复现检查点、18K SFT 样本与三阶段训练配方,支持 vLLM/SGLang。
Hugging Face 分享 ML Intern 复现工作
Hugging Face 转引 Niels Rogge,称团队利用开源研究 harness ML Intern 复现了一篇论文,并可用于训练模型。输入没有给出被复现论文的完整身份与结果,不能扩写具体指标。
DeepSpeed 修复 ZeRO-1/2 梯度保存
Stas Bekman 分享 DeepSpeed PR #8949:在请求边界与优化器 step 不一致时,梯度应保留至真正 step。作者建议升级到 deepspeed >= 0.19.9;具体修复以该 PR 为依据。
Inferact 扩大与月之暗面合作
据 @woosuk_k 发布:Kimi K3.1 Pro 发布同时,双方扩大合作以优化该模型的服务与部署。
OCRia-1 报告单 B200 加速结果
LlamaIndex 转引 Jerry Liu,称 OCRia-1 文档解析吞吐在单张 B200 上从 285 提升至约 2800 tok/s。约 10 倍是该模型与硬件条件下的报告值,并非所有文档任务的通用加速比。
LoCo 学习何时结束推理
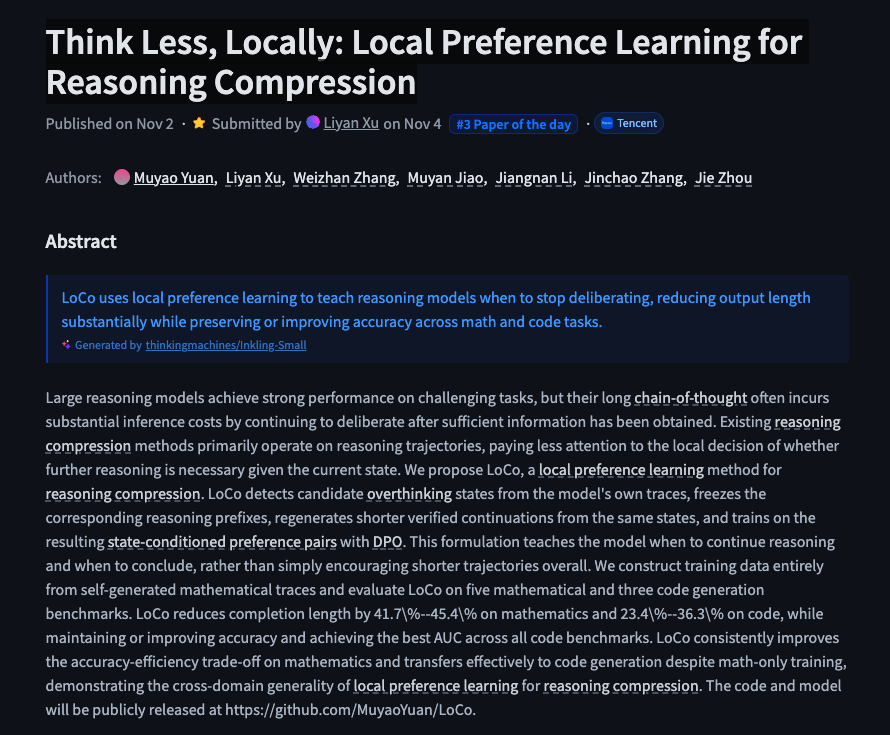
论文提出 LoCo:从模型自身数学轨迹中识别过度思考状态,构造更短且已验证的续写,再用 DPO 学习局部偏好。作者报告在 5 个数学、3 个代码基准上,输出长度分别减少 41.7%–45.4% 和 23.4%–36.3%,准确率保持或提升;结果限于论文测试范围。
RoboColosseum 开放真实机器人评测
Hugging Face 宣布成为 RoboColosseum 创始合作伙伴。该计划称覆盖 100 多台真实机器人、140 多个真实场景,所有执行轨迹连同失败案例都在 Hub 开放,强调评测过程可检查。
Liber-0 探索从人类经验迁移到机器人
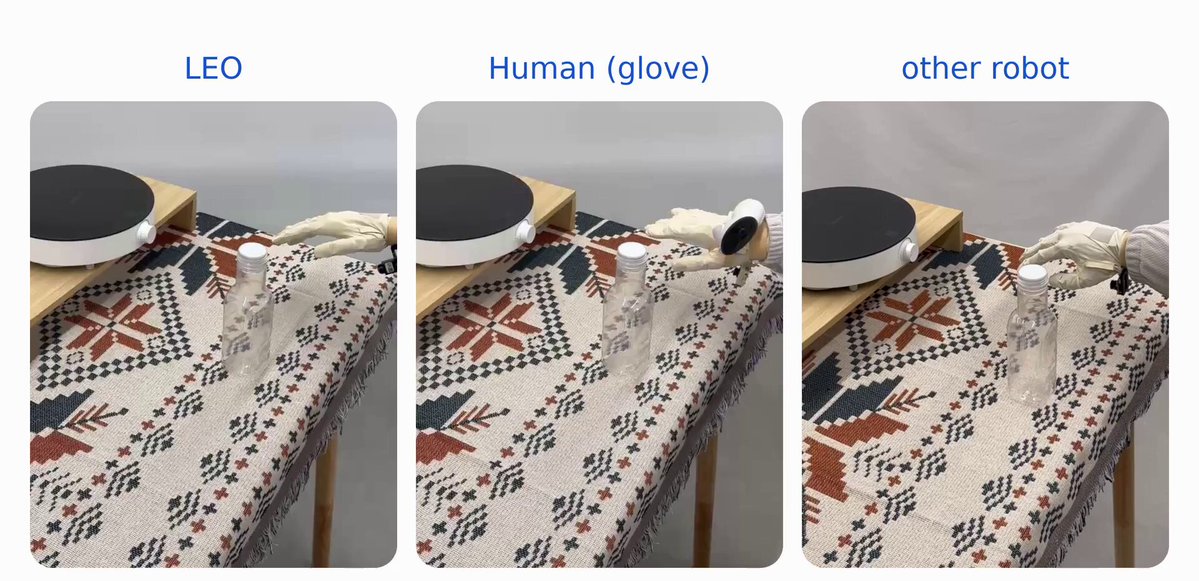
arankomatsuzaki 介绍 LiberAI 的 Liber-0,称其使用超过 220 万小时人类经验预训练,在目标任务零机器人演示条件下,60 项任务、600 次试验成功率为 36.0%。数字来自该发布转述,不能外推为任意任务的成功率。
子代理状态更新成本降约 99%
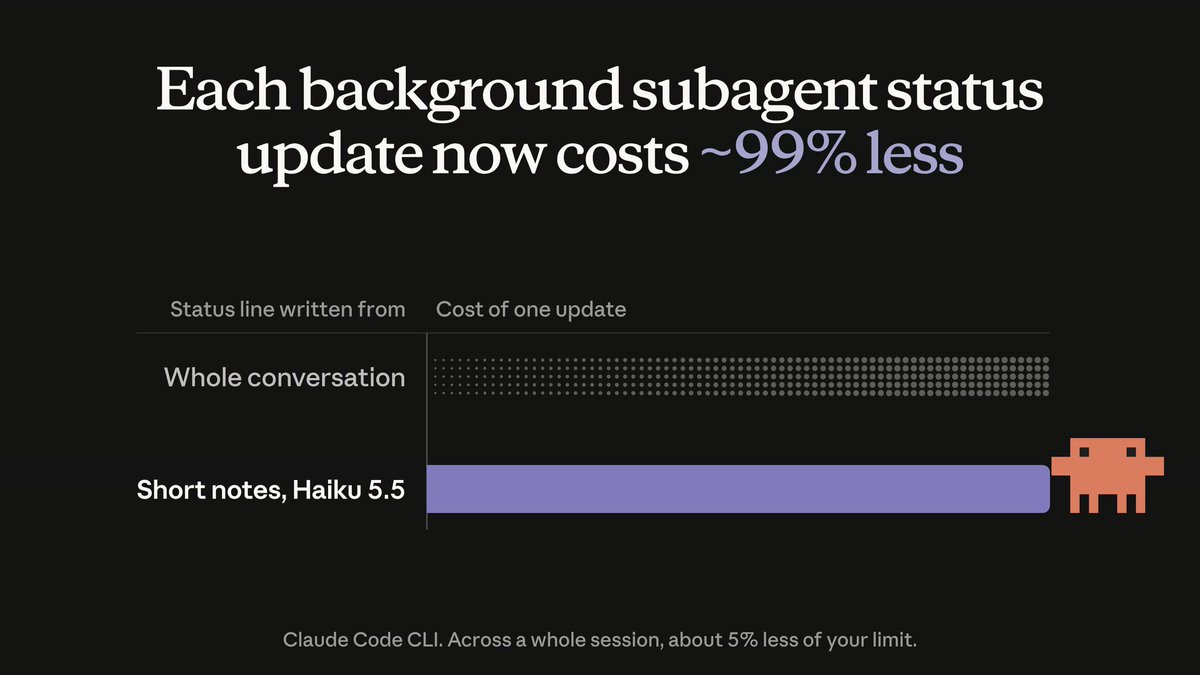
Claude 开发者团队称,后台子代理每 30 秒更新状态行时,过去会重读整段对话,现在改由 Haiku 5.5 从短笔记生成,单次更新成本降低约 99%。这一比例只针对状态更新,不是整个 Claude Code 任务的总成本。
Mistral 演示 133 个代理协同修洞
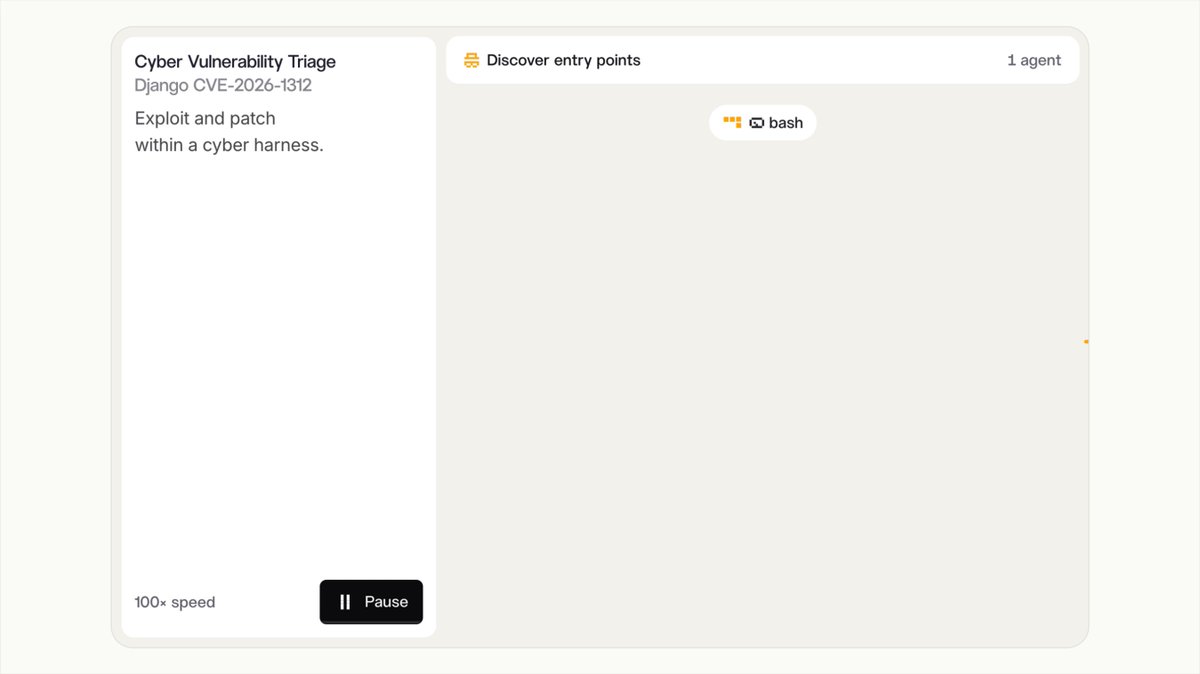
Mistral 以一个近期 Django CVE 演示 Large 4 工作流:133 个代理负责代码梳理、漏洞搜索、攻击场景测试和确认,再由 Le Chonk 修补。演示以 90 倍速播放,不代表实际处理耗时。
OpenAI 欢迎 Pierre 团队加入
Greg Brockman 欢迎 Pierre Computer 加入 OpenAI,并表示其开源开发者工具已支撑 Codex 的部分功能。该动态强调 AI 软件协作工具的整合,没有披露交易金额。
Altman 转发部分套餐用量翻倍消息
Sam Altman 转发产品团队公告,称 Pro 100、200、500 档与 Business Premium 的用量限制即日起翻倍。原始片段没有给出完整产品范围和计量规则,应以账户内说明为准。
Fast Search 将接入 Perplexity 决策 API
Arav Srinivas 表示,Perplexity 正把 Fast Search 整合进 Decisions API,使批量决策获得网页事实依据。帖中列出搜索每请求 0.001 美元;决策 API 的 0.02 美元报价后文被截断,输入不足以确定完整计费单位。
Perplexity 披露广告投放案例
据 Perplexity 的客户案例,Computer 为 Get Maine Lobster 管理 3 万美元 Meta 广告,较其常规广告带来 3.5 倍收入、63% 更高 ROAS,并自动化创意分析、制作及媒体购买。结果属于特定客户的发布方案例,不能外推为所有投放的收益保证。
Runway Dev 插件接入 Claude Code
据 @runwayml 发布:开发者可在 Claude Code 中直接生成 Runway 视频、图像和音频 API 集成代码。
Synthesia 视频生成接入 ChatGPT
据 @synthesiaIO 发布:可在 ChatGPT 中构思、生成并自动化视频,通过插件完成从想法到成片。
Perplexity Computer 可建动画网站
据 @AravSrinivas 发布:借助 MotionSites 技能生成带 WebGL 着色器与滚动动画的网站。
Replit 用户用 AI 搭建工单路由应用
据 @amasad 发布:运营负责人用 Replit 构建支持工单优先级、上下文补全与工作流路由应用。
马斯克介绍 Grok Bot 购物流程
马斯克称 Grok Bot 能研究购物方案、列出候选、下单、跟踪购买并退回不想要的商品。原帖没有给出适用范围、成功率或权限机制,属于发布方能力描述。
转推展示 Grok Bot 电话询价
马斯克转引一位用户的体验:让 Grok Bot 给充电桩安装商打电话询价,并查看通话用量。原始片段没有留下完整计量数字,不能据此估算通话价格。
Grok Bot Pages 使用教程
马斯克转发 @mattyp 的 Pages 教程,目录包括页面介绍、示例、分享以及结合用户数据和 X 帖子的技巧。这是一则功能教程,不代表 Pages 当天首次推出。
Grok Bot 被用于整理提示词库
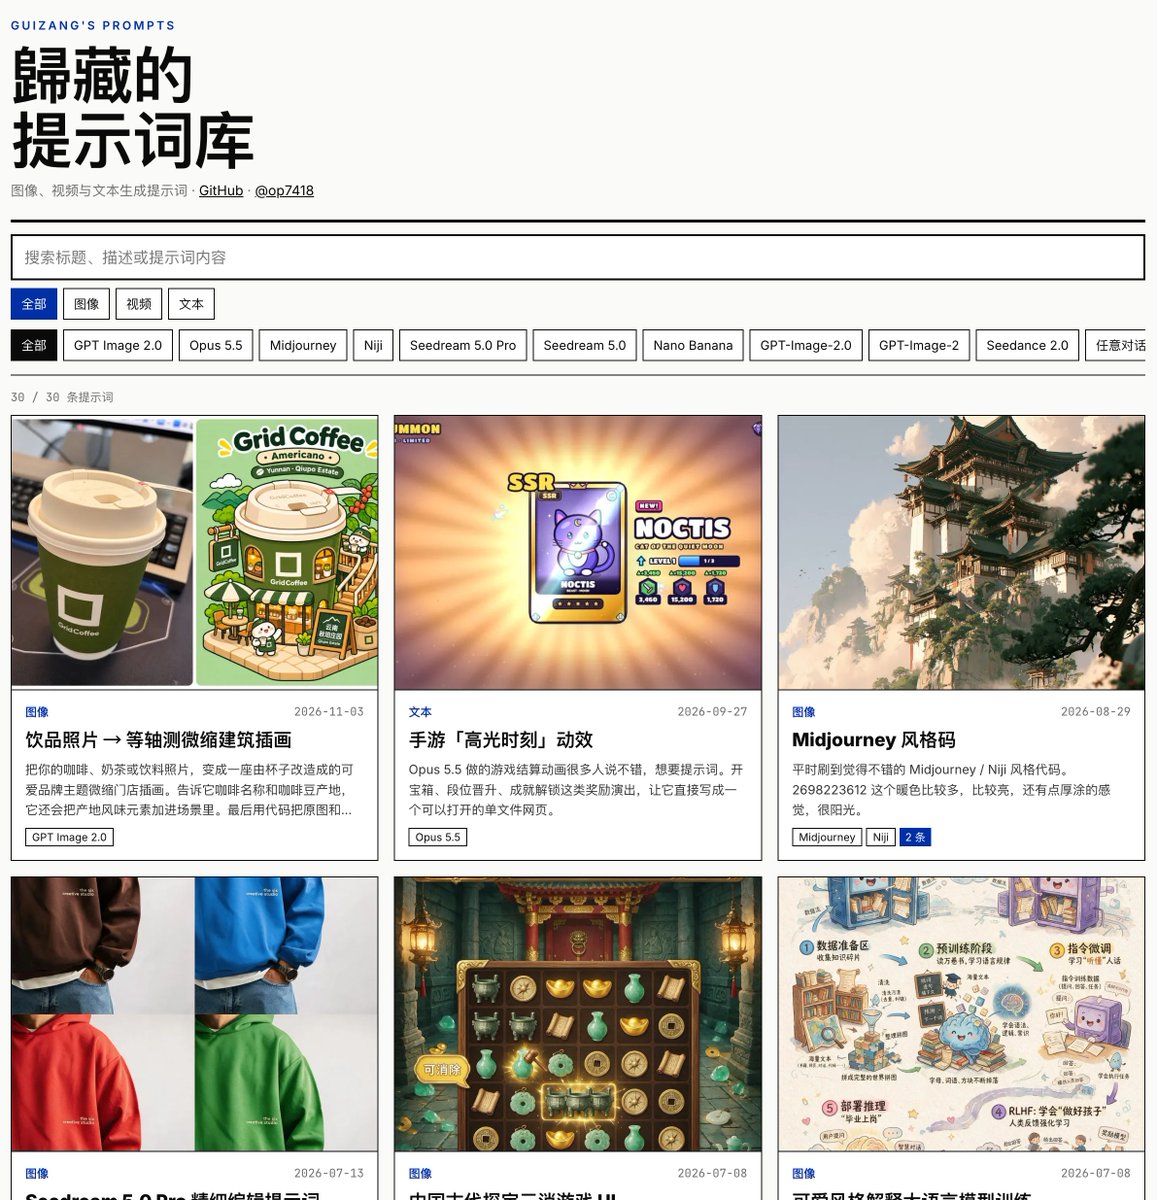
歸藏称,因自己的信息多已公开发在 X,他让 Grok Bot 用一句话建立了个人图像与视频模型提示词库。这是特定用户的工作流案例,不代表已核实的普遍成功率。
Living Brain 将记忆与模型解耦
据 @_akhaliq 发布:为 ChatGPT、Claude、Cursor、Codex 与自建代理提供持久记忆层。
转推介绍 4B 端侧计算机使用模型
_akhaliq 转引 Niels Rogge,介绍微软的 Mage-VL-Cowork:一款 4B 端侧 computer-use 模型,并提到社区演示。领先性能是转述中的发布说法,输入未含完整评测条件。
LlamaParse 取消用量上限
据 @llama_index 发布:新增按量付费与 Pro 自助档,按每千 credits 1.50/1.25 美元计费,现有档位同步取消上限。
员工终端 AI 智能体成安全风险
据 @amasad 发布:推文警告企业员工端点上的 AI 代理可能形成系统性安全风险,需要治理。
Brockman 披露漏洞管线成本
Greg Brockman 称 OpenAI 已发现、验证并准备近千个 Linux 本地提权漏洞补丁,成本约为每个漏洞 1000 美元。他将其描述为规模化加固软件的一条新路径;这是同一漏洞管线的成本补充说明。
保留 Rust 构建缓存改善 AI 开发体验
宝玉转引 huacnlee 的经验:多 worktree 自动化 AI 开发中,不再删除 target 目录后,避免了全新编译,机器也不再因反复构建卡顿。这是个人环境的观察,不能推广成通用磁盘优化结论。
Baoyu Design 更新本地生成结果入口
宝玉介绍 baoyu-design 的 DeepSeek Harness 插件更新,为 Slides、Design、Dashboard 与 Motion 结果提供统一入口。项目以 Agent Skill 在本地生成独立 HTML,支持 Cursor、Codex 等工具;这是工具更新而非本站功能。
Cicada 提供 macOS 实时翻译与纪要
开源原生 macOS 应用 Cicada 为会议和直播提供实时双语字幕、同声传译与 AI 纪要。项目说明覆盖 Zoom、腾讯会议、飞书和 YouTube,并可经虚拟麦克风向会议软件输出译后语音。
DeepMind 招聘 AI 产品工程人才
宝玉分享 Google DeepMind 招聘消息,方向为构建 AI Studio 和 Gemini API。短帖没有具体岗位要求和申请条件,应继续查看原始招聘信息。
DeepMind 蒙特利尔招学生研究员
S D Ebrahimi 转发 Kory Mathewson 的招聘信息,面向本科、硕士或博士学生研究员,地点为 Google DeepMind 蒙特利尔。具体研究方向在输入中截断,不沿用评分摘要补出的课题。
Claude 参与细菌 vault 颗粒结构研究
Anthropic 介绍生物学团队与 Claude 合作,绘制来自细菌生命的 vault 颗粒首个三维结构。公告将这类桶状蛋白复合体描述为长期研究谜题;输入未包含完整实验方法,不能据此推定 Claude 独立完成研究。
权重编辑新增 NanoJev 对战案例
Omar Khattab 转引实验称,仅编辑 NanoJev 0.0002% 的权重,在 100 场头对头测试中取得 65 胜、34 负、1 平。原文任务名被截断;这是特定实验的报告,不代表所有任务可用同样比例改进。
MIT 权重空间研究获转发关注
Omar Khattab 转发 Gabe Pereyra 对 MIT 研究的评论,片段提到 GPT-6 Astra 读取 Qwen 模型权重。输入没有完整实验细节,不据此推断其理解所有权重或能可靠修改任意模型。
权重空间方法探索 VLM 安全对齐
Omar Khattab 转引研究者尝试把权重空间方法用于视觉语言模型安全对齐。输入在测试名称处截断,未包含完整结果,不能宣称安全对齐已经成功。
手写小模型权重识别法律引用
Omar Khattab 转引 @jacsebl,称用 fable 手写一个 10 万参数模型的权重,以区分真假法律引用。输入未包含准确率与独立测试,不等同于可用于专业法律核验的产品。
Harvey 支持权重空间编程研究
Omar Khattab 感谢 Harvey 团队对权重空间编程研究的支持,并提及 Harvey 过去在相关领域的开放贡献。输入未披露具体资助金额或合作条款。
征集模型权重修改操作轨迹
Omar Khattab 转发 @mann_idan 的征集:购买工程师修改模型权重及相关工程任务的操作轨迹。原帖没有说明完整用途或交易条件,不把它扩写成已经发布的数据集。
让训练算法适应“算力孤岛”
Arohan 的文章主张,训练算法应与现实可用、分散在不同数据中心的算力协同设计。推文讨论拼接单个低于 20MW 的数据中心;不能将其改写为整个训练集群总功耗低于 20MW,也不是已复现的成本结论。
让长期运行模型的笔记更易读
@jxmnop 观察到,模型长时间工作后所写笔记会越来越难理解,少量训练能够改善这种情况。这是关于笔记可读性的经验说明,输入没有给出通用训练配方或评测数据。
Route Anything 探索统一路由
_akhaliq 转引论文介绍,称 Route Anything 以一个路由器覆盖语言模型、图像、视频和语音生成器、编码代理及机器人策略。原文在 374,401 这个数字后截断,不能确定其统计对象。
JEPA 与 LLM 表征的讨论
Yann LeCun 转发 antirez 对柏拉图表征假说、JEPA 与 LLM 隐藏状态的讨论。输入只保留了开头,呈现的是研究议题,不能推出双方表征等价或某种架构已胜出。
能量基推理论文预告
LeCun 转引 Alexi Gladstein,预告 Energy-Based Reasoning 研究,并转述其优于循环推理的主张。输入未给出论文或实验,因此不将预告中的比较当作已验证结果。
媒体报道 LeCun 小模型研究
LeCun 转发 Numerama 对他与 Randall Balestriero 研究的介绍,提到 10 月 29 日上线的论文。原始片段在“小模型”论述中截断,输入不足以确认评分摘要所声称的完整推理结论。
INFORMS 的 JEPA 研究演讲预告
LeCun 转发 Randall Balestriero 在旧金山 INFORMS 介绍最新 JEPA 研究的演讲通知。原始动态是会场预告,没有提供完整论文或新实验数据。
LeCun 谈陈述性知识
LeCun 转发自己的观点,称 LLM 积累大量陈述性知识,因此能回答很多问题。输入在后续论证处截断,保留这条直接表态,不补写对完整推理能力的结论。
小测试讨论 Codex 与文本检测器
Arvind Narayanan 转引 Sayash Kapoor 的小规模测试,称简单提示就可让 Codex 绕过 Pangram 检测。这是有限测试中的转述结果,不证明所有文本都能稳定绕过检测。
内核智能体实验追问是否仍需 DSL
据 @Tim_Dettmers 发布:推文讨论内核智能体实验后,ML 编译器与领域特定语言是否仍必要。
视觉符号可能影响模型行为
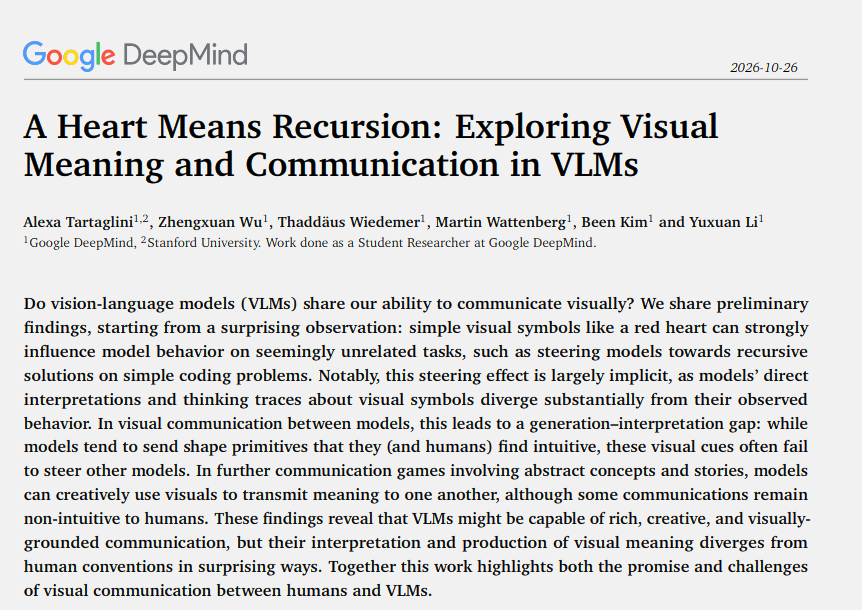
Ethan Mollick 分享一篇 AI 符号学论文,称视觉符号可影响模型反应,而模型在思维链中未必识别这种影响;模型对符号的解释也可能不同于人类。此处是他的论文解读,未独立复核实验。
Pika H3 Flex 正式上线创作平台
据 @pika_labs 发布:支持快于实时的创作迭代,Creator 与 Fancy 订阅者至 11 月 15 日每日 15 次免费生成。
Pika H3 Flex 开源权重催生 Turbo LoRA
据 @pika_labs 发布:发布不到 24 小时,社区做出 2 步草稿、4 步快速与 8 步 HD 变体,兼容 ComfyUI 与 Diffusers。
Kling 4.0 Flash 全面开放
据 @Kling_ai 发布:网站与 API 均可使用,并支持 MCP、CLI 和 AI 插件接入视频工作流。
Luma 推出角色一致性表
据 @LumaLabsAI 发布:Character Sheet 将参考图整理为统一角色表,减少多视角生成时角色漂移。
Recraft 展示生成与动画组合流程
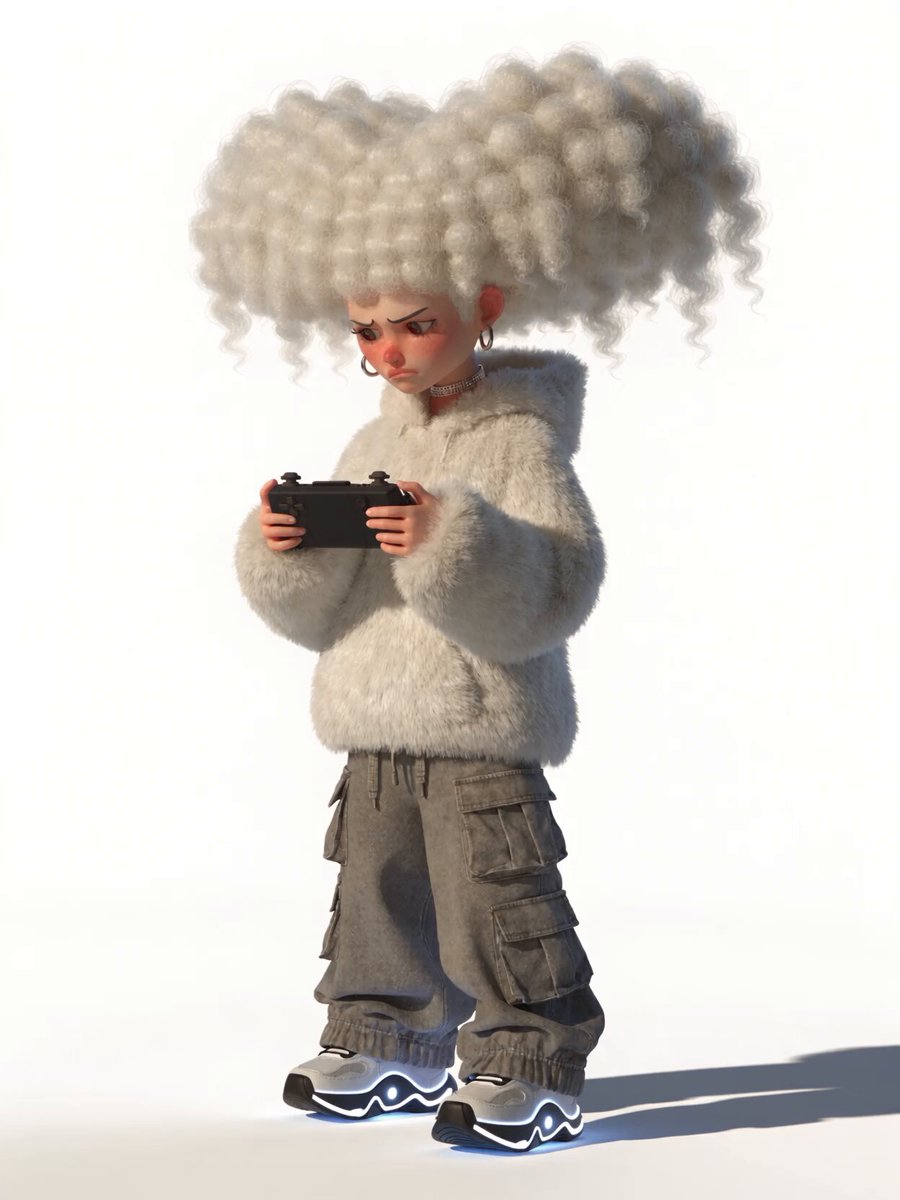
Recraft 展示用 V4.1 生成角色、再通过 Seedance 2.5 制作动画的工作流,全部在 Recraft 内完成。该条是创作案例,不足以断言相关集成就在当天首次上线。
PixVerse 上线深度图动作控制
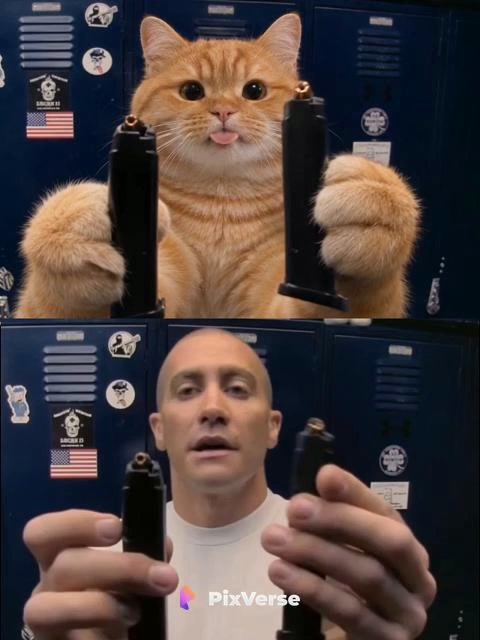
据 @PixVerse_ 发布:上传参考视频作为深度控制,替换角色、物体或场景并生成相同运动。
Kimi 3D Worlds 即时生成可漫游场景
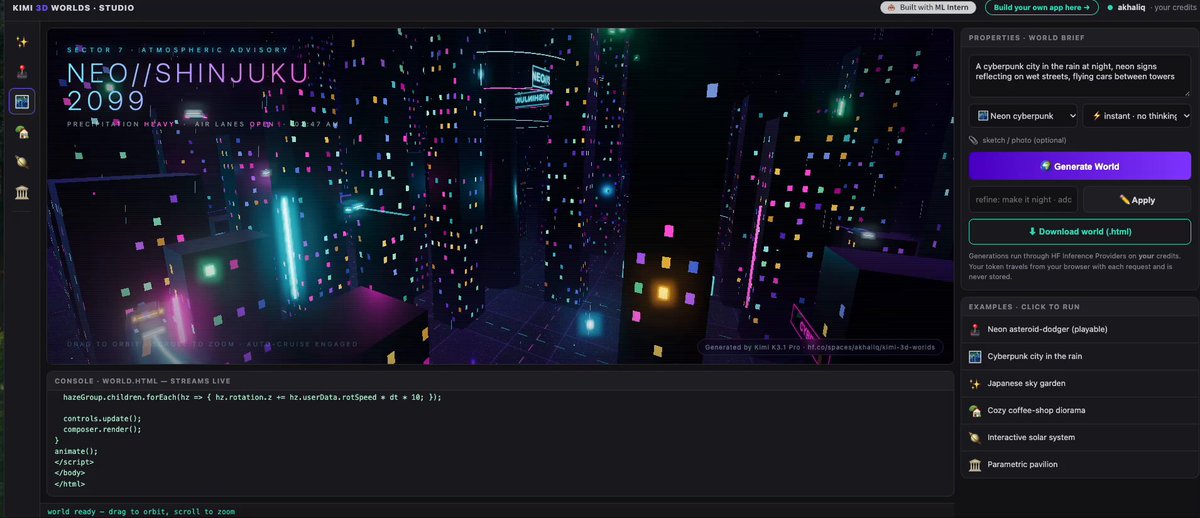
据 @_akhaliq 发布:输入场景描述或草图,即可生成全屏 Three.js 3D 世界,在浏览器中探索。
MoviEdit 简化长视频多镜头编辑
据 @_akhaliq 发布:用文本或单帧编辑视频,并重新渲染所有镜头,面向长格式多镜头场景。
HYPER3D 预告提示词编辑骨骼绑定
_akhaliq 转发 Deemos 的 HYPER3D Rigging 公告,介绍对人物、动物、幻想生物的自动绑定,并可用提示词调整。原文在细节处截断,不把评分摘要的“单根手指”精度当作已确认能力。
Kling 展示面向电影镜头的创作测试
Kling 分享 Ash Koosha 使用 Kling 4.0 的案例:衡量生成镜头能否放进长片。他的创作标准与经验不是统一质量基准,输入也没有给出定量结果。
Vidu Q4 展示武侠美学生成
据 @ViduAI_official 发布:通过光影、构图与色彩提示生成日落决斗、竹林、雪地独行等电影感场景。
Unreal Engine 5.9 预告 AI 工作流
Tom 转发 Unreal Engine 公告,称 5.9 将于下周进入 Preview,包含改进的 AI 工作流和 Web 目标支持。预告不等于稳定版已经发布。
Tesseract 宣传代理生成三维内容
CoffeeVectors 转引 Mirage 公告,称 Opus 5.5 或 Astra 配合 Tesseract 可创建带路径追踪渲染的三维内容。“专业级”是发布方描述,输入没有提供独立质量评测。
Tesseract 展示互动三维角色场景
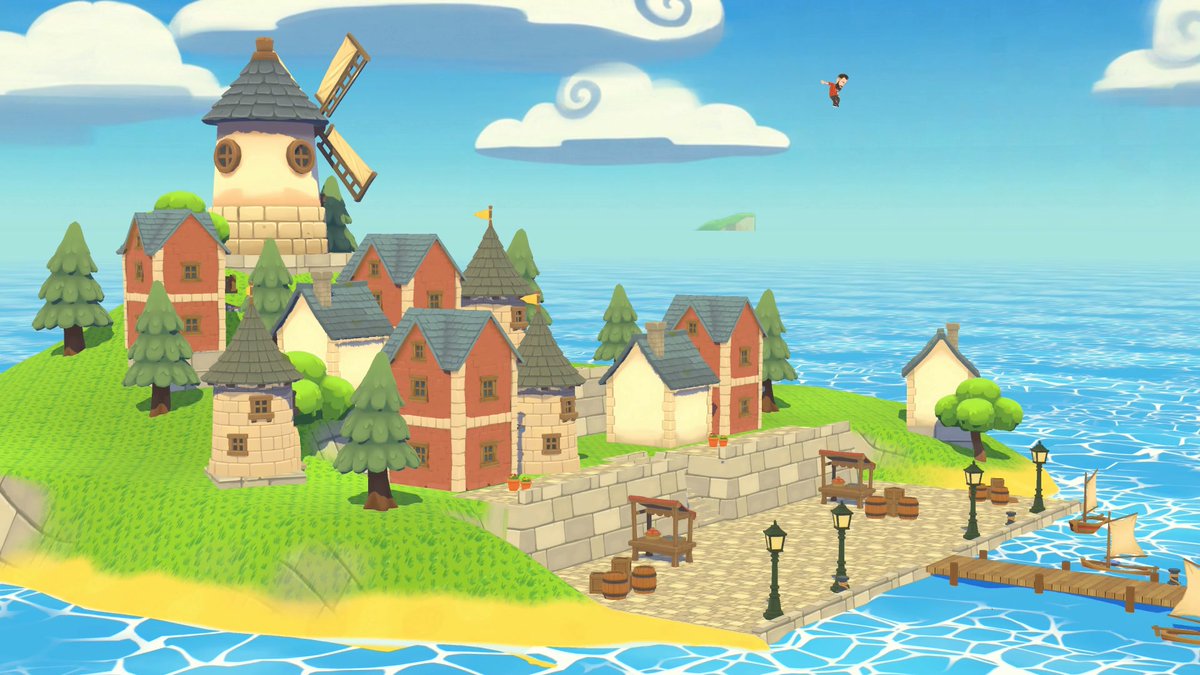
Linus Ekenstam 分享用 Mirage 的 Tesseract 制作的三维场景,自己作为游戏角色与渔夫对话。该条展示创作玩法,没有证明角色对话、世界生成或渲染的通用质量。
AI 一键复制引出创作归属问题
CoffeeVectors 转引创作者 Kevin Parry 的担忧:视频被 AI 一键复制后,更难判断最初由谁创作。这是对内容归属的行业观察,不是已经量化的平台趋势。
AI 角色对白也需要表演指导
CoffeeVectors 转引创作建议:AI 角色声音不自然时,可以先检查提示词里的对白写法和表演指导。该建议来自个人实践,没有量化效果承诺。
创作者谈 Muse 视频模型体验
歸藏评论 Muse 视频模型在部分真实场景的表现,并认为免费可用有助于传播。输入是个人体验与判断,没有完整型号、可用范围或横向评测。
Glif 介绍 AI 模特 Claudia
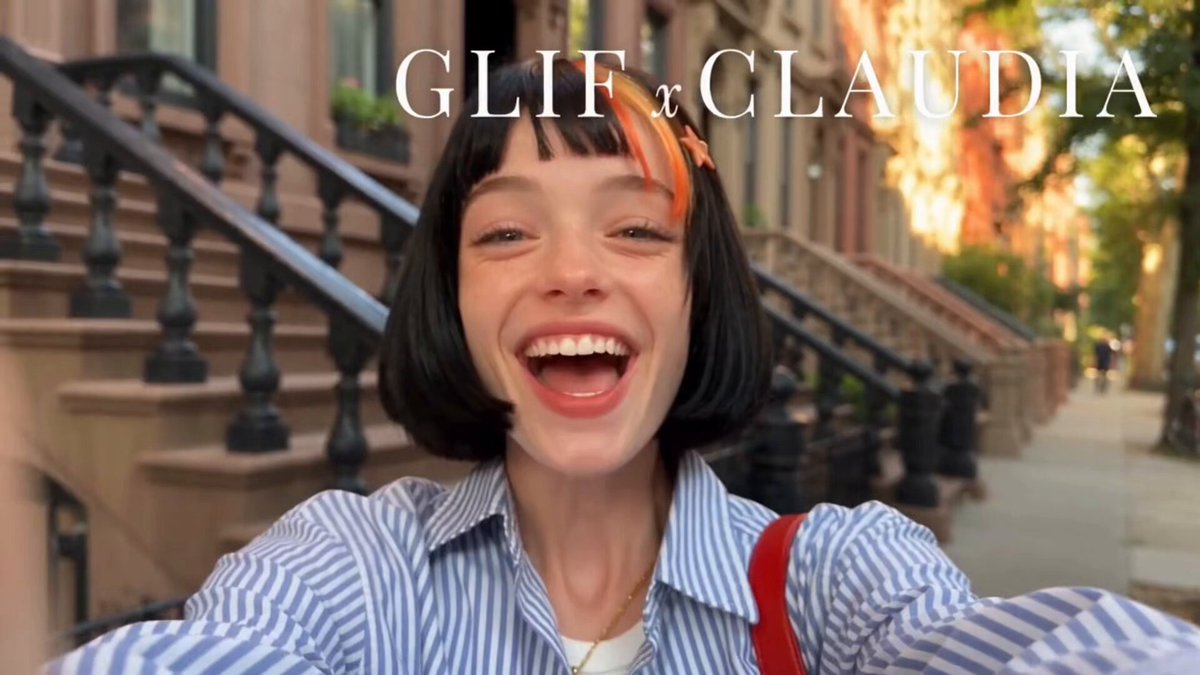
Glif 宣布签下 AI 模特 Claudia,供广告和微短剧选角,并称相关内容有 4400 万浏览。其官网将产品描述为在聊天中结合图像、视频与音频生成的创作代理;浏览数据为发布方自报。
Altman:人应始终掌控未来
据 @sama 发布:OpenAI 反对让人类退居 AI 认为应奖励的角色,强调人应始终掌控未来。
Chollet:AI 应始终是人的工具
据 @fchollet 发布:他认为值得构建的未来,是 AI 留在人类手中并用于提升人类境况。
李开复:AI 转型要瞄准 CEO 难题
据 @kaifulee 发布:企业能列 AI 试点却难说业务结果,关键是把最强技术用于最难问题。
Interconnects 汇总开放模型经济数据
Nathan Lambert 表示,公开免费的 Interconnects 看板汇集开放模型经济数据;新的解读系列则会作为付费内容提供。免费数据看板与付费解释属于不同产品部分。
与 AI 共事需持续重校准认知
据 @random_walker 发布:AI 能力与岗位定义每隔几月变化,需避免生产力幻觉,也要避免被威胁感裹挟。
转推讨论大规模代码交付经验
马斯克转引 @poteto 的 AI Engineer 演讲预告,片段提到代码产出扩大 30 倍。原文在质量控制说明处截断,不能将其当作已经核实的 30 倍生产力或质量不变结论。
购物被低估的 Agent 用例
据 @elonmusk 发布:推文认为购物是每周高频痛点,比编码演示更贴近普通用户,适合代理自动化。
吴恩达分享 AI 工程师岗位观察
吴恩达援引 LinkedIn 研究称,7 至 9 月间 AI Engineer 在七大经济体均进入增长最快的前十类职业。他同时预告纽约 AI Dev 将于 11 月 30 日至 12 月 1 日举行;“前十”不等于增长第一。
中国开放模型实验室按时交付权重
据 @natolambert 发布:评论指出中国实验室在权重发布时间上持续兑现承诺,未来若延期将具信号意义。
可维护性也应审视人工代码
CoffeeVectors 转引开发者观点:讨论 AI 代码可维护性时,也不应默认人写代码天然可维护。输入仅有观点开头,没有提供人机代码质量对照实验。
AI 促使重新思考人类智能
CoffeeVectors 转引 Hinton 的观点,称 AI 正迫使人们重新思考人类智能。原话后续部分截断,保留议题,不补全引文或把它当作科学定论。
待核实:博主介绍 Siri 应用调用进展
歸藏发帖称 App Intents 能让开发者选择向 Siri 开放应用功能。输入仅有博主转述,没有苹果官方公告、版本与适用设备信息;具体新增能力和上线范围仍待核实。
待核实:Claude 产品负责人离职消息
歸藏称 Claude Code 与 Cowork 的产品负责人 Cat 已离职,并转述其否认 IPO 锁定期是考虑因素。输入没有本人原始声明,离职消息仍待核实,不推断原因或公司内部状况。
宝玉谈 AI 创作与读者需求
宝玉讨论 AI 时代图书创作的分化,认为部分作者会使用 AI 创作,而读者仍可能愿意阅读。原帖列举未完整展示,这里只保留可读的观点,不补全所谓三类图书。
Axiom 引出大规模 AI 代码讨论
Linus Ekenstam 将 Axiom 围绕 Stacks Project 的工作作为讨论大规模 AI 代码质量的例子。输入在项目介绍中截断,没有完整方法、覆盖规模或验证结果,不补写具体成果。
购物代理让品牌面临新的可见性问题
Linus Ekenstam 观察到,用户开始向代理询问买什么,品牌却难以看到聊天中如何作出选择。这是一条关于代理购物与品牌触达的判断,没有量化市场份额。
Polsia 案例:让代理尝试融资
Linus Ekenstam 转述,Ben 把邮箱交给 AI,并提出筹资 1000 万美元的目标;相关帖子约获 10 万浏览,带动 Polsia 的早期关注。目标金额不等于已经完成融资。
@oran_ge
警惕把持续改代码当作持续进展
永远有下一件事可做
橘子转述一个开发者不断让 Claude 和 Codex 改产品、消耗 token 的故事,提醒构建过程容易制造有产出的感觉。这是一则个人评论;原始故事后半段截断,不据此断定项目已经失败。