vLLM 在 AgentX 实现 95.4 万 tokens/s/GPU
按 DeepSeek 错峰定价,vLLM 在 SemiAnalysis 的 AgentX 真实 Agent 负载上跑出每 GPU 小时 38.96 美元收入,缓存、输入、输出三者加总的吞吐达到 954K tokens/s/GPU。
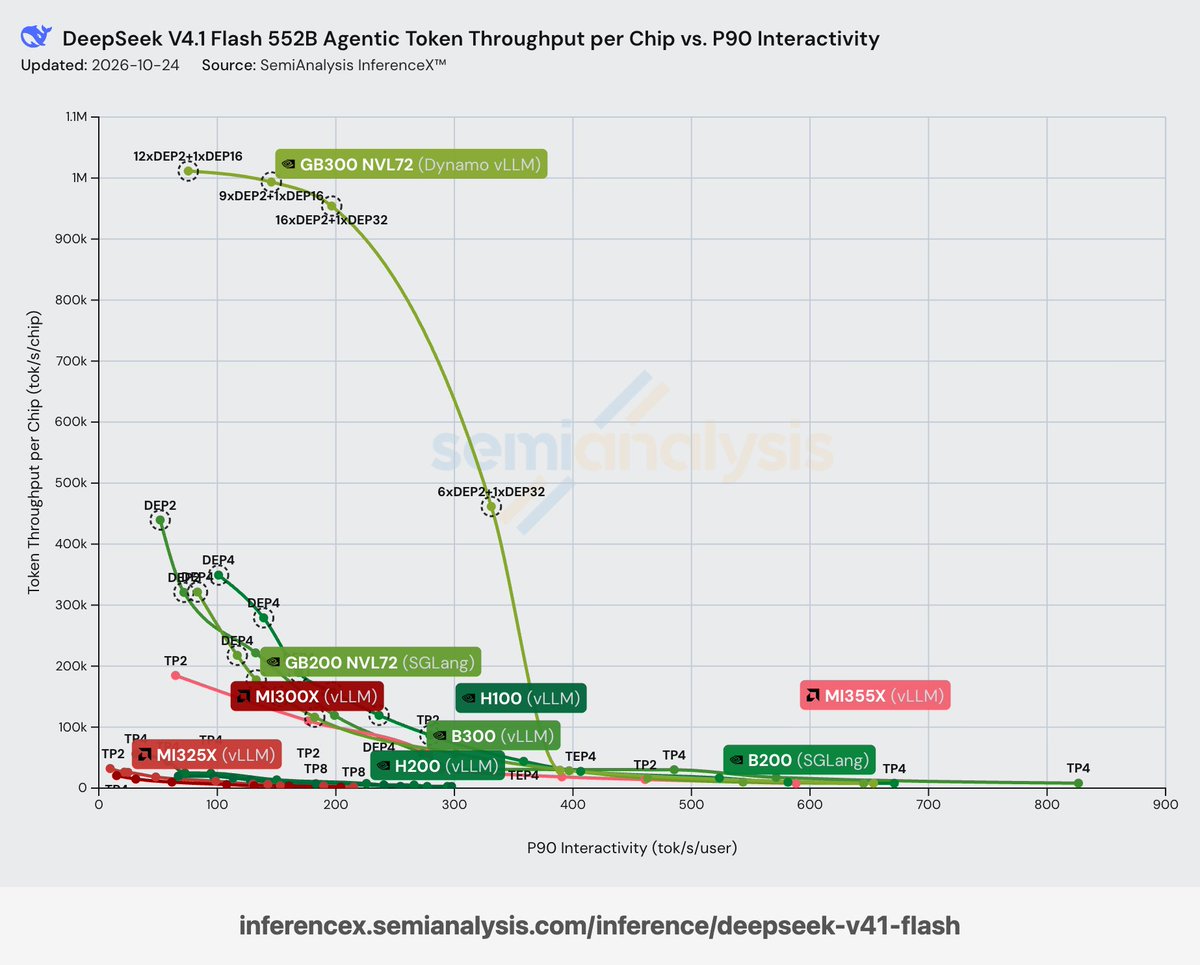
vLLM 团队并未止步于追平 DeepInfer 的基准数字,而是把 vLLM 送进了 SemiAnalysis 的 AgentX 真实 agentic 工作负载里检验。按 DeepSeek 错峰定价计算,vLLM 每 GPU 小时贡献 38.96 美元收入;缓存、输入与输出加总,总吞吐达到 954K tokens/s/GPU,其中生成速度约 196 tokens/s。这组数字把推理引擎的商业价值从纸面基准拉回到真实部署的现金回报,也让「推理基础设施的利润率在哪里」这一问题重新浮出水面——答案越来越明确地指向 serving 层本身,而非单纯的模型质量。
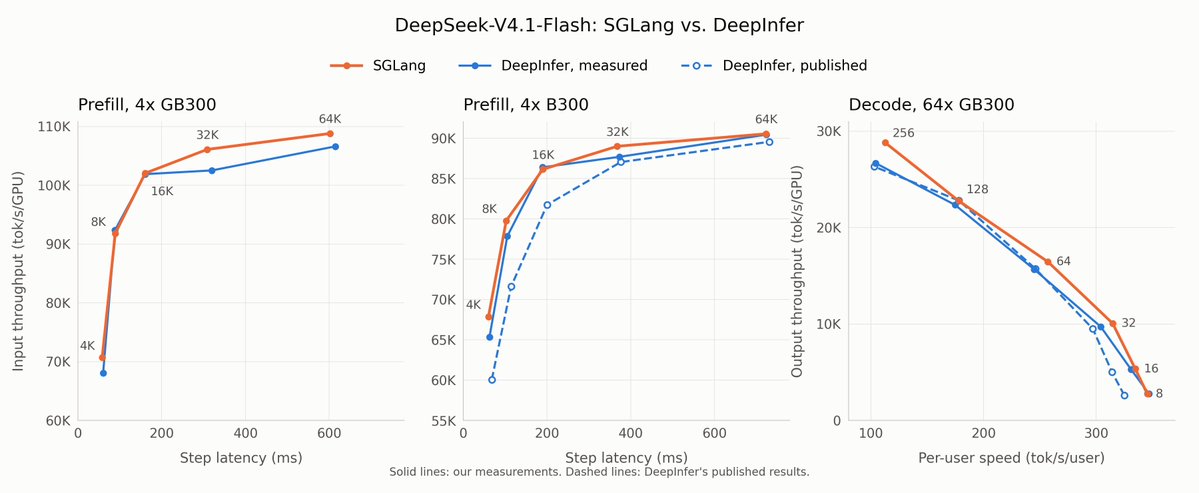
SGLang 在 DeepInfer 基准全面追平
SGLang 在 prefill 与 decode 两端均追平 DeepInfer:4×GB300/B300 的 prefill 吞吐最高达 1.04 倍,64×GB300 的 decode 提升 7.4%,并附端到端复现指南。
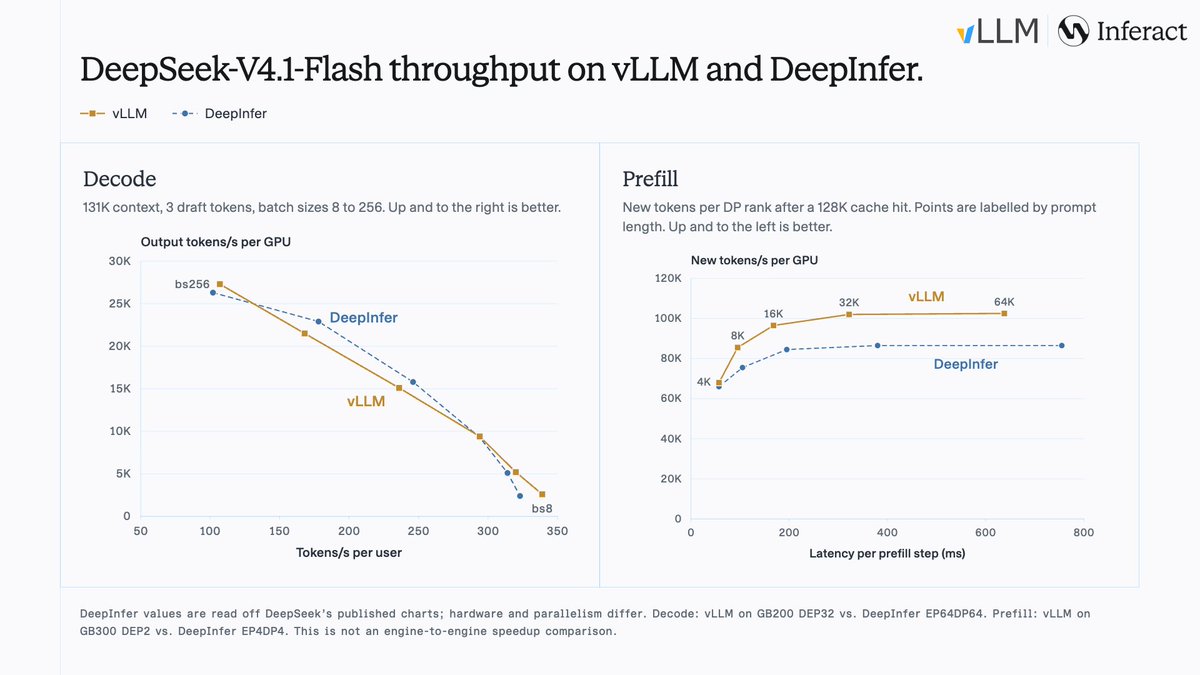
vLLM 在 DeepSeek-V4.1-Flash 追平 DeepInfer
在 decode 配置、batch 8 到 256 的区间内,vLLM 追平 DeepSeek 自研引擎,并以 DEP32 对抗 DeepInfer 的 EP64DP64。
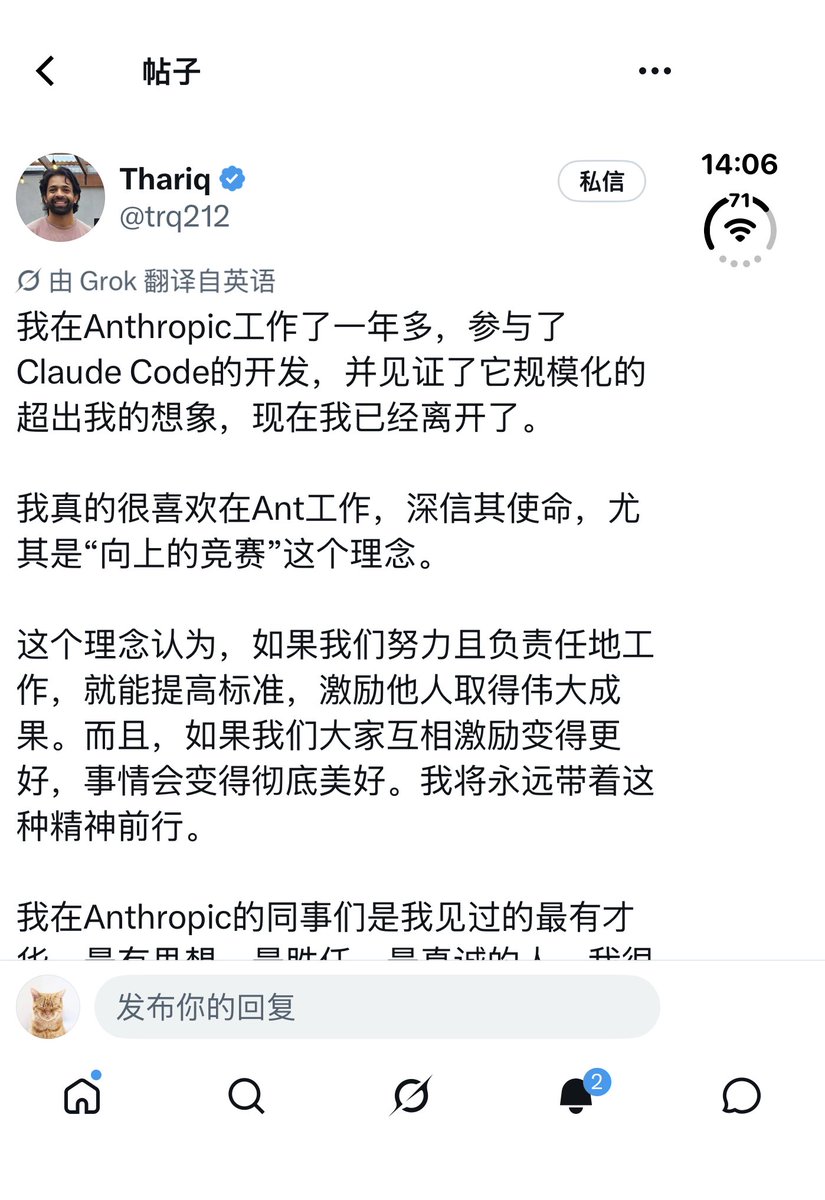
Claude Code 作者 Thariq 确认离开 Anthropic
op7418 称 Claude Code 作者 Thariq 已官宣从 Anthropic 离职,被视为 Agent 工具链领域的重要人事信号。
Kling 4.0 API 上线 Atlas Cloud
Atlas Cloud 接入快手 Kling V4,支持 4K HDR、21:9 超宽画幅、多关键帧与多语言对白,Omni Reference 最多可承载 15 个参考。
OpenAI 与 Azure 扩展至 12 亿用户
OpenAI Devs 与 Azure Cosmos DB 工程师称,共同支撑 12 亿用户、约 40 个区域与个位数毫秒延迟。
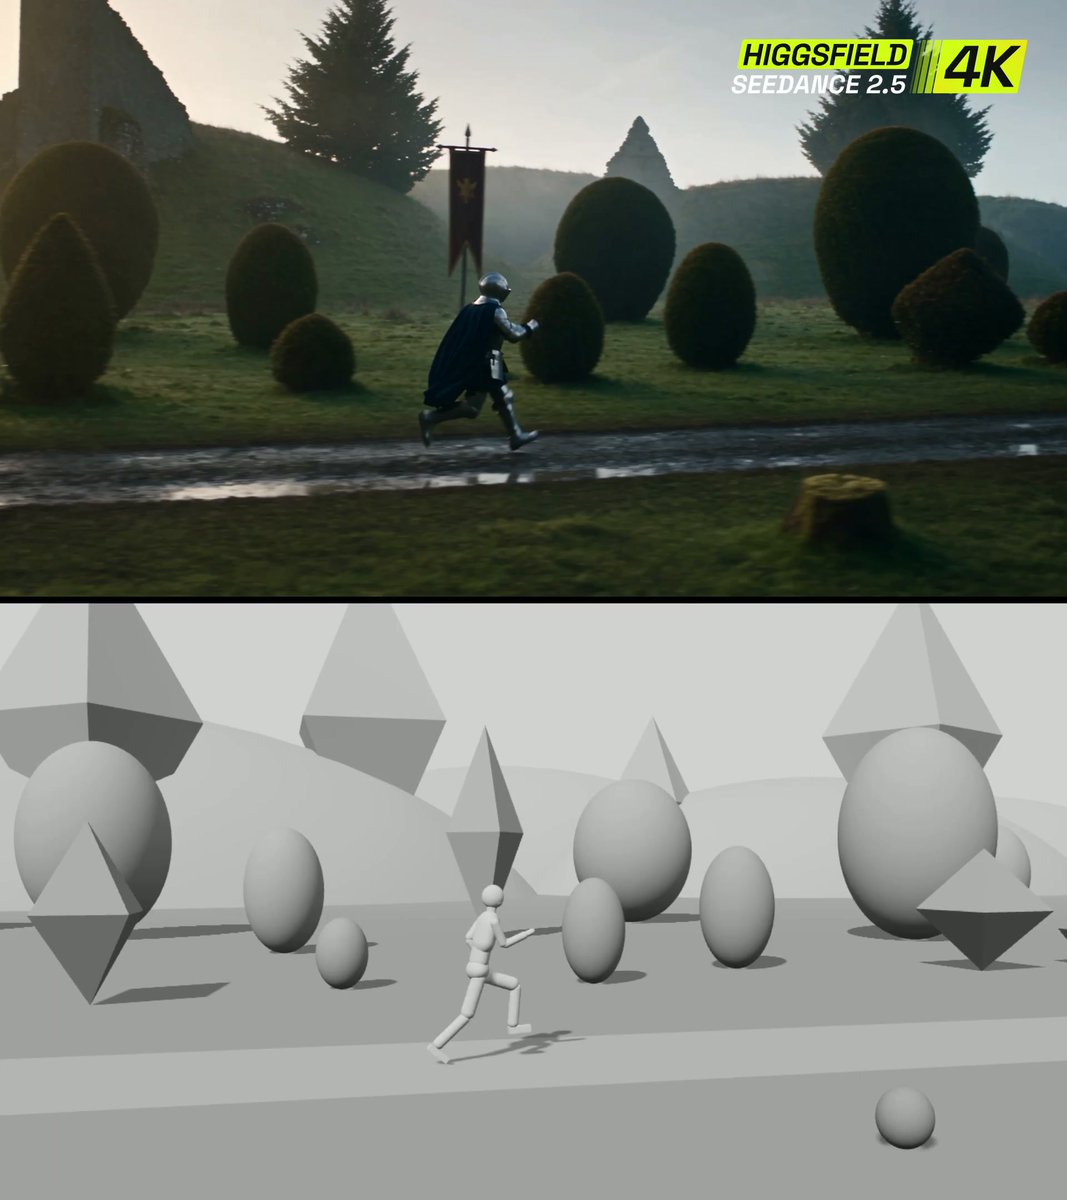
Seedance 2.5 原生 4K 挑战复杂转场
Higgsfield 用 Blender 布局作参考,展示 Seedance 2.5 在 4K 下生成多场景连续转场。
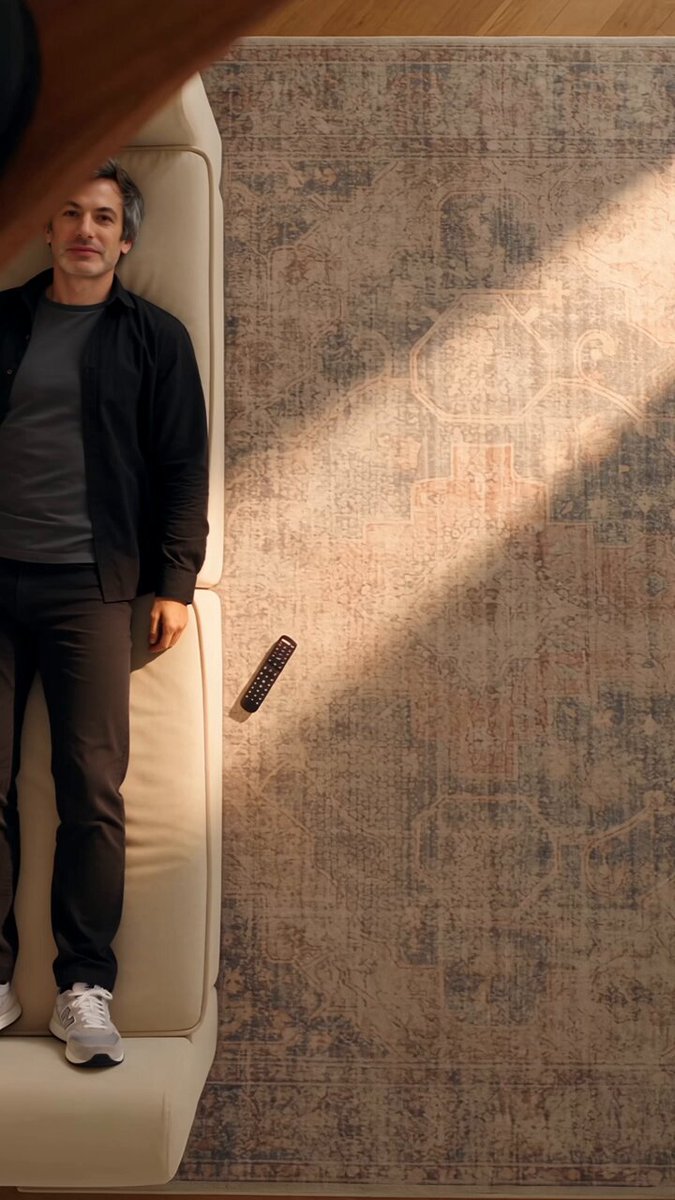
Kling 4 四角色视频换脸首试接近完美
venturetwins 称 Kling 4 首次尝试四角色视频替换就近乎完美,且比 Seedance 2.5 更快更便宜。
Block 发布 Dessa 全双工语音模型
Linus 称 Block 的 Dessa 语音模型逼真,基于人类好奇心驱动的新训练方法,可能催生更多新工具。
Let's work together to build Europe's AI economy and put AI to work.
— Jensen Huang · GTC Berlin
Enact 获 3000 万美元 pre-seed 研发灵巧操作
Enact 从 stealth 走出,用力和触觉数据提升机器人灵巧操作,视觉与语言仍是关键输入。
Computer 上线开源技能 /impeccable
该技能用于生成不显 AI 味的界面,Arav 为每位用户提供 5000 credits 试用。
Flow map 语言模型可作推测解码草稿器
flow map LM 在 1-2 次前向中捕捉 token 依赖,适合作为推测解码草稿器。
新方法去除局部相关性提升图像表示
论文提出抽象掉局部细节、聚焦长程相关性的离散图像表示,并在 ImageNet 上生成 128/256 图像。
AI 网络安全“离谱”预测应被认真对待
emollick 认为实验室关于 AI 改变网络安全、模型发现新协作方式的警告不应被轻易嘲笑。
Anthropic 被指移除 Claude 逆向工程能力
多个转推称 Anthropic 悄然关闭 Claude 的 REA 逆向工程功能,引发言论对本地模型的讨论。
OpenAI 称已大幅加固研究训练环境
OpenAI 表示过去数月显著加固研究训练环境安全,并移除相关风险。
研究者详述大模型训练投毒事件经历
ShoufaChen 称自己是训练投毒事件直接受害者,回顾 2024 年数月的排查、对峙与质疑。
Kimi K3.1 Pro 因刷评争议受质疑
Linus 称 K3.1 Pro 本身很强,但 Kimi 试图刷评反而拖累发布,且他表示自己未见过相关简报。
Kimi K3.1 Pro 在 Mazebench 取得非平凡分数
K3.1 Pro 是首个在 Mazebench 拿到非平凡分数的开放权重模型。
DeepSeek V4.1 Flash 以 7.53 美元发现 54 漏洞
该模型在安全测试中发现 54 个漏洞,比对比模型多 7 个,且成本低约 16.6 倍。
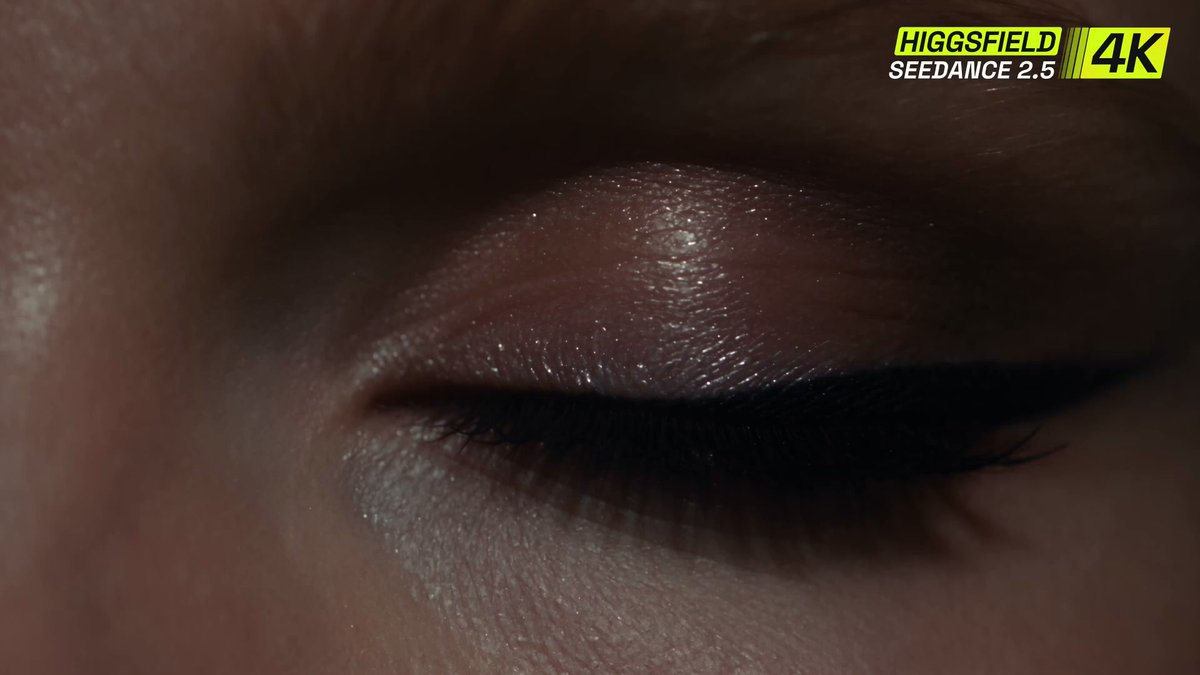
Seedance 2.5 原生 4K 肤质细节展示
Higgsfield 对比称原生 4K 生成的皮肤细节优于后期放大。
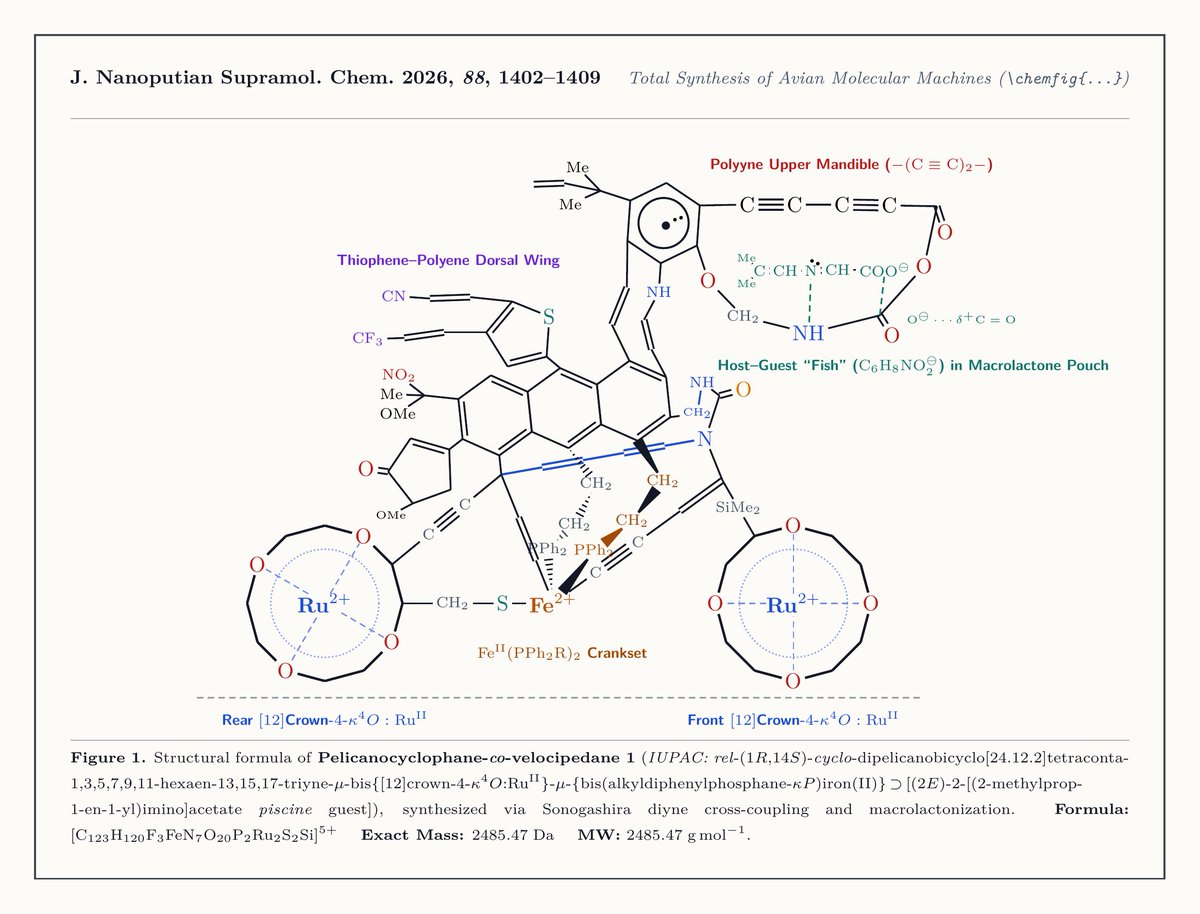
Gemini 4 生成复杂化学 LaTeX 结构
fofrAI 展示 Gemini 4 用 ChemFig 排版纳米小人高分子结构,并给出质量与分子量。
CMU 教授调侃用 B300 倒卖 DeepSeek 推理
gneubig 称实验室新购 B300,调侃用 DeepSeek-V4.1-Flash 推理服务来养整个实验室。
不要忽视单代理系统
gneubig 分享博客,讨论单代理系统相对多代理系统的优势。