Anthropic 正式登陆纳斯达克
Anthropic 于美国时间 11 月 19 日开始在纳斯达克交易,代码为 ANT,前一日公布的 IPO 发行价为每股 83 美元。CEO Dario Amodei 在上市致辞中重申,公司成立是为了让强大的 AI 技术造福人类;这次进展是开始交易,与此前定价公告区分。
GPT-Live-1.1 向 API 开发者开放
OpenAI 将 GPT-Live-1.1 开放到 API,强调多语言口音一致性和任务可靠性。新的 standby 选项可在 WebRTC 会话暂停推理时降低闲置费用;这不是首次进入 ChatGPT,模型此前已用于其语音功能。
Ideogram 4.6 主打原生 4K 精确编辑
Ideogram 于 11 月 19 日发布 4.6,支持原生最高 4K 生成和多轮精确编辑。官方称其减少编辑区域外的像素漂移,并改善色彩、纹理与真实感;生成与 Precise Edit 接口面向不同工作流。
Codex 进入 ChatGPT 性能维护流程
OpenAI 介绍 Performance Factory:性能告警触发后,智能体调查回归、记录发现并提出修复,由工程师审阅,再检查生产效果。其流程把任务状态、派发、云端执行和事件唤醒连起来,人工审查仍是关键环节。
GPT-6.2 推理复用要求保留对话前缀
Responses API 可沿用先前推理,但 GPT-6.2 起推理项与此前对话绑定:改写前面的消息可能使推理项被丢弃,影响缓存和后续 token 用量。官方文档建议保持前缀不变,并用 input_transformations 排查移除原因。
Muse Wonder 获法律基准最高质量分
Meta 称 Muse Wonder 在 Legora 11 月 BAR 法律工作基准中获得最高综合质量分。这是特定法律任务评测的结果,不能直接等同于所有法律场景的可靠性。
Kimi 转发 K3.1 Pro 的 SII 对比
Kimi 转发 Fireworks 的结果,称 K3.1 Pro 在 SII 的 17 个实践者基准中有 14 项超过 K3。当前采集内容未给出完整比较设置,本条保留测试来源,不扩展为全面领先。
Qwen4-Max 可在 Nous Portal 试用
Qwen 官方邀请开发者通过 Nous Portal 使用 Qwen4-Max,并分享创作结果。这条动态更新的是可用入口,模型发布本身已在此前报道。
Perplexity 更新开放权重决策模型
Hugging Face 转发 Perplexity 的 pplx-decider-v1.3 和 pplx-decider-flash-v1.3 发布动态。二者属于开放权重决策模型;当前短公告未提供足够细节来比较具体任务收益。
OVHcloud 推出 Olala mini 7A1B
OVHcloud 宣布 Olala mini 7A1B,作为其首个语言模型家族的开端,Hugging Face 转发该发布。当前材料提供型号与发布方向,未给出可独立比较的完整性能表。
Nous 为 Qwen3.8-27B 发布 Hermes 适配器
Hugging Face 转发 NousResearch 的 Hermes adapter,目标模型为 Qwen3.8-27B,主打智能体效率与准确性。效果应按适配器对应的任务和执行框架理解。
Cloudflare Clairic 面向信息抽取
Hugging Face 转发 Clairic 发布,介绍其从内容中抽取信息,而不只输出决策结果。采集到的是模型简介,没有完整字段规范或准确率结果。
PAN 2 同时提供权重与训练代码
Clement Delangue 转发 IFM 的 PAN 2 公告:除权重外,还提供推理代码、训练代码及 Apache 2 许可。动态强调开放程度需要看完整材料,而非仅是否能下载权重。
本地语音助手模型引起关注
Clement Delangue 转发 Nemotron 3.5 Bolt E4B 的介绍,称其为面向本地语音助手的约 4GB 模型。当前为二手简介,不据此推导所有设备上的速度或内存承诺。
Marin Mochi 开放 57 个中间检查点
Marin 发布 Mochi 535B-A23B 预训练的 57 个中间检查点,其中包括 10 个长上下文扩展阶段检查点。此次材料让研究者能观察训练过程,而不只是最终权重。
Hy4-flash 的 Maya 引擎仍在 PR 阶段
腾讯转发 Project Maya PR #1040,新增独立 maya-hy4 引擎,涵盖张量并行、MTP 草稿与 CPU 专家通道。原动态称即将合并,因此不把提案写成已进入主分支。
OpenCode 提供 Hy4 flash 免费入口
腾讯官方表示可通过 OpenCode 免费访问 Hy4 flash,并邀请开发者测试。公告未写明额度和持续时间,具体可用条件需以服务入口为准。
腾讯披露 Hy4 的 ChessQA 排名
腾讯称 Hy4 在 ChessQA 任务中排名第二。原动态未列出完整榜单、配置和测量日期,因此这里仅记录官方发布的单项评测信息。
离散扩散用于 16×16 像素画
Hugging Face 转发一个离散扩散像素画模型,将小尺寸精灵图作为生成对象。它展示离散表示在像素创作中的用途,当前动态没有足够资料判断规模化效果。
Replit 推进长时程 Missions
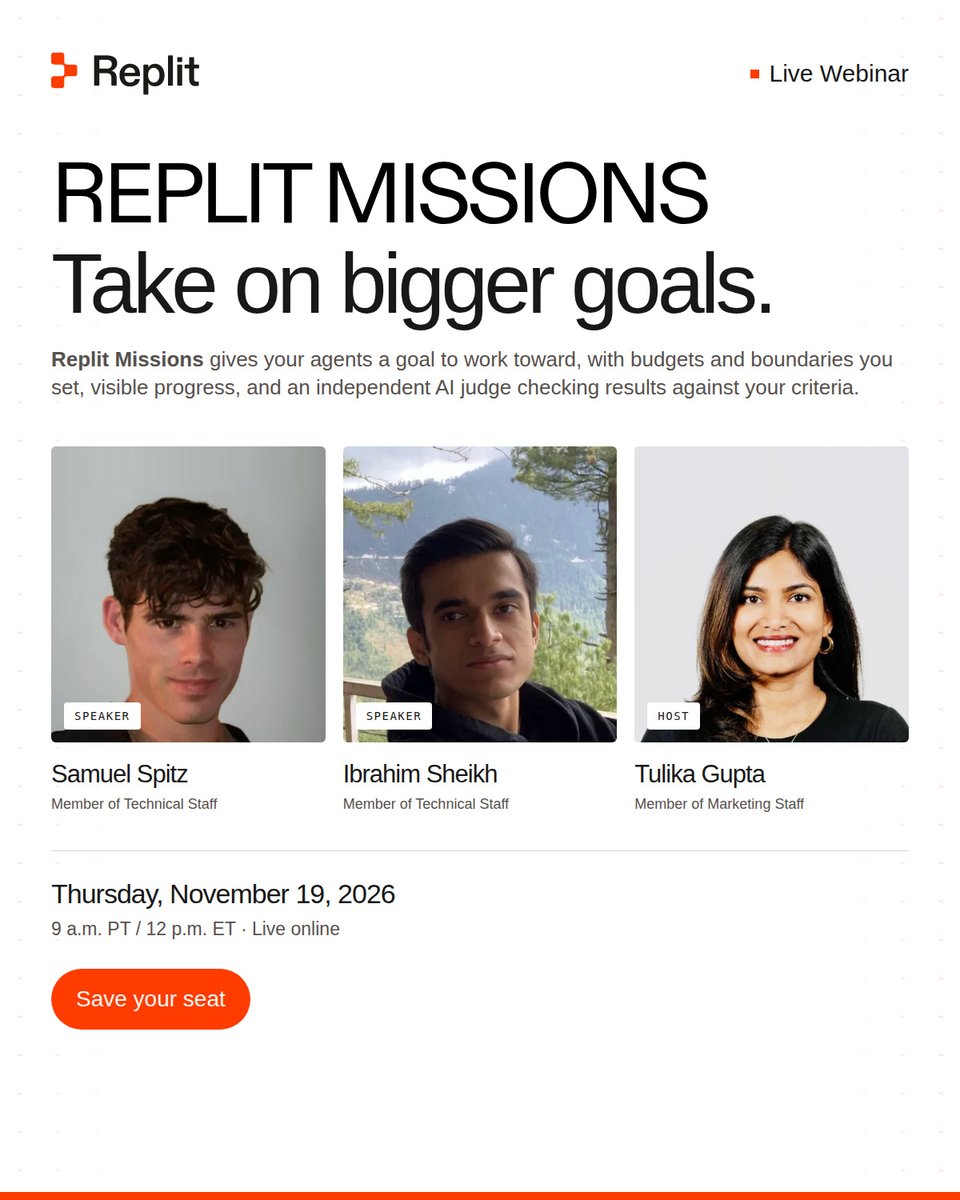
Replit 再次介绍 Missions,让智能体群围绕用户目标执行任务。公告回顾其 Agent 的自主工作时长从早期版本扩展到 200 分钟以上;该数字描述此前演进,不能直接当作 Missions 的新时长承诺。
智能体团队需要明确责任与共享发现
Replit 的协作研究强调清晰任务归属、共享发现和减少协调开销。增加智能体数量本身并不等于更好的团队表现,研究关注的是如何让执行互相衔接。
Replit 开放自托管助手 amuse
Replit 展示用 Missions 在三天内构建的 amuse:自托管个人助手支持研究、浏览器、提醒和小应用,并在行动前请求批准。仓库说明其运行在用户电脑上,调用模型仍需 OpenAI 密钥。
Claude Code 团队重新定义审查目标
Claude Code 团队博客讨论 AI 代码产量上升后的审查瓶颈:在维持审查覆盖与深度的同时,以回滚率、事故率不增加为约束,减少人工审阅时间。重点从有没有人看过,转向审查是否降低真实风险。
Perplexity Brain 自动整理可复用技能
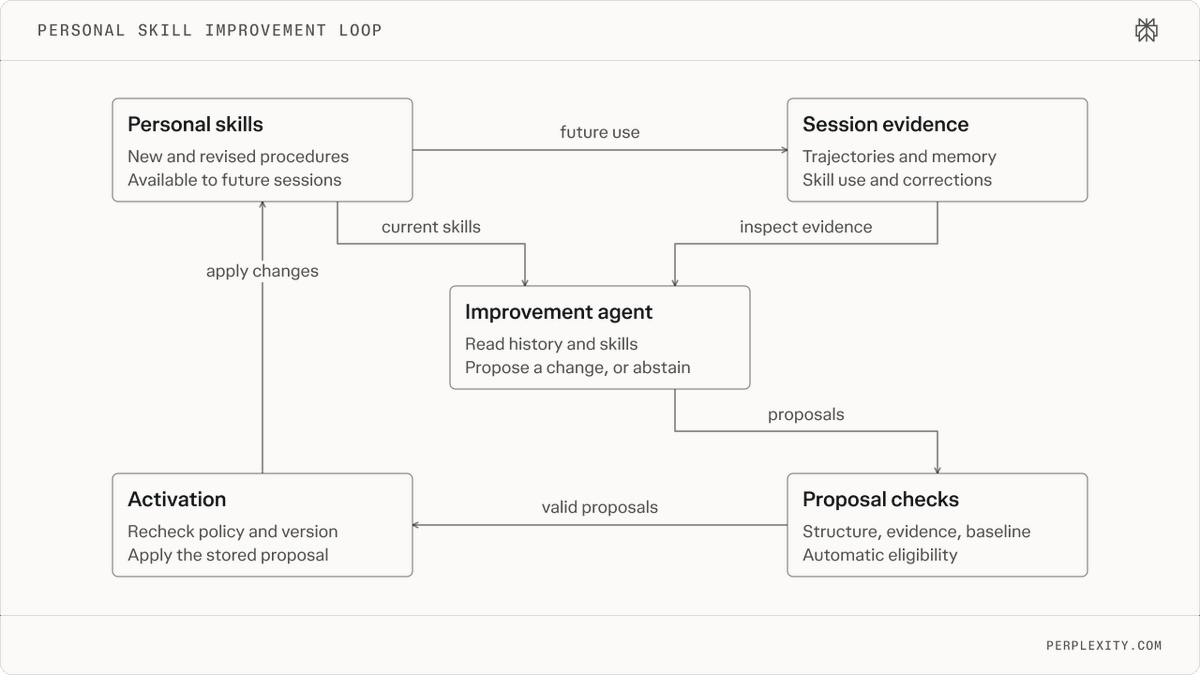
Perplexity 称 Brain 会读取以往会话与记忆,为未来任务编写、更新个性化 agent skills。这里的自我改进是工作流与技能更新,不等于底层模型权重自动训练。
Perplexity Teammates 支持移动端呼叫
Perplexity 表示 teammates 已进入 iOS 和 Android 应用,并可从应用中呼叫。此前围绕代码、应用和业务工作的智能体,由此增加移动交互入口。
Decider 免费试用再延长三周
Arav Srinivas 宣布在 OpenRouter 上将 Perplexity Decider-v1.3 及 Flash 的免费使用延长三周,并自报其决策模型请求份额接近 20%。该比例属于其所述平台口径。
Context API 增加提示注入检测
Arav Srinivas 称 Context API 集成决策模型,用于提示注入检查及自定义条件过滤。这是为智能体抓取结果增加判断层,不代表能保证清除所有恶意内容。
Perplexity 介绍三类智能体 API
Perplexity 介绍近几日推出的 Monitor、Orchestrator 与 Context:分别处理事件告警、按任务路由模型,以及把 URL 批量转换为智能体可用内容。三者覆盖发现、调用和资料准备。
Vercel Board 定位为智能体基础设施
Guillermo Rauch 将 Vercel Board 比作智能体的无头 Slack:重点是基础设施,面向不同用例再生成相应界面。这是产品定位说明,不是所有 UI 成本消失的量化结论。
留言板成为智能体协作的基础部件
Guillermo Rauch 分享智能体留言板方向,强调协作信息的共享与可见性。他把留言板与近期科研、安全项目联系起来;具体成果仍需分别评估,不能仅凭共享消息归因。
SRE-1 用强化学习定位生产告警根因
ResolveAI 发布 27B 模型 SRE-1 技术报告,面向生产事故调查和根因定位。Stas Bekman 介绍其训练使用 DeepSpeed 与 Snowflake 的 Cortex Training;性价比优势来自作者评估。
Runway 介绍视频模型控制机器人
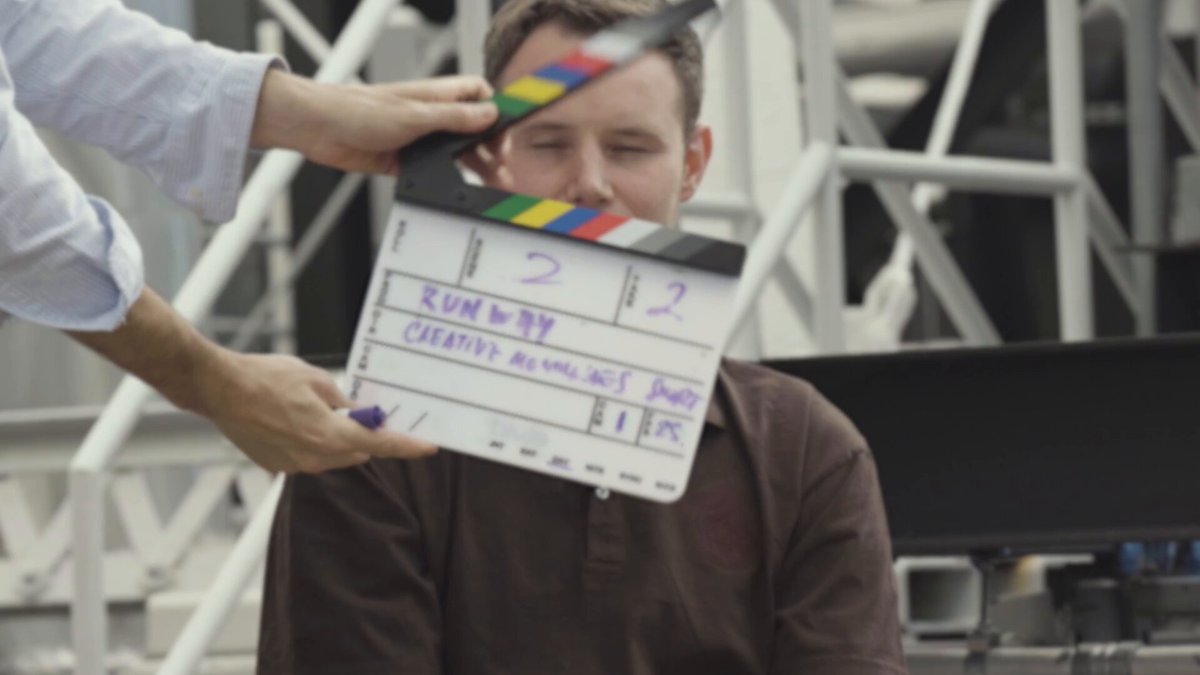
Runway 的 Inside View 节目介绍 Praxis-1,利用机器人看到的画面引导下一步动作。内容展示视频模型进入控制回路的方向,并非新的全场景机器人成功率报告。
GR00T 2 展示真实灵巧手控制
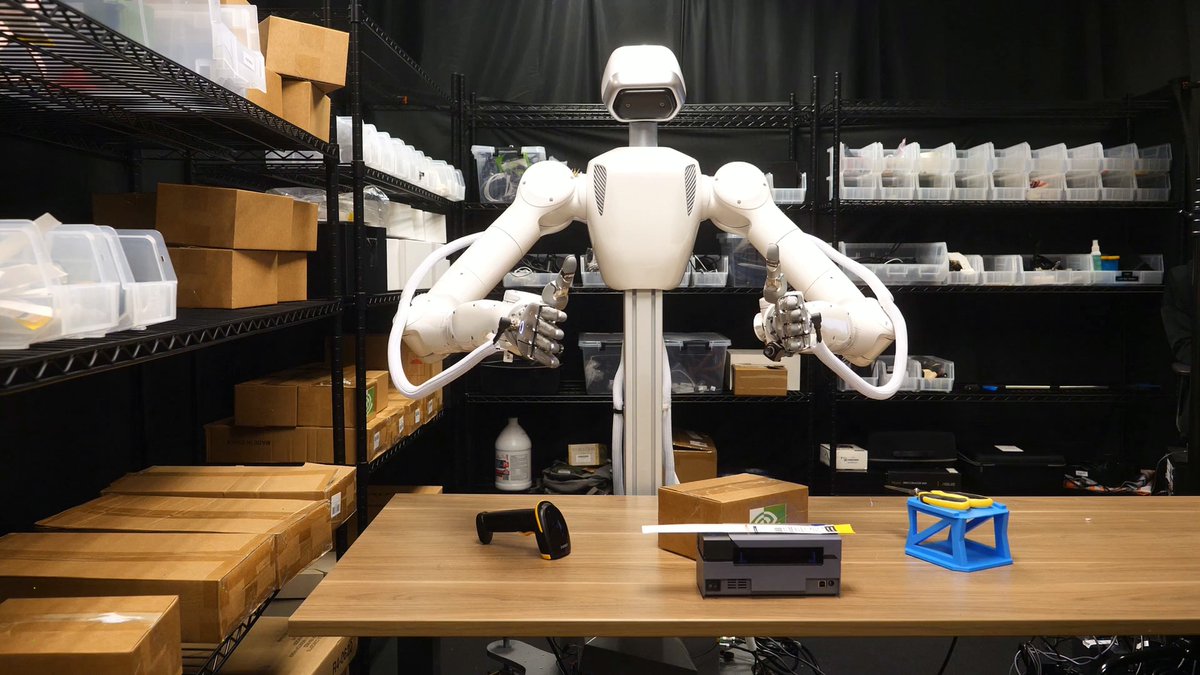
Jim Fan 分享 GR00T 2 端到端控制真实灵巧手的视频,并将其标注为自主、未剪辑、原速演示。该条是单段能力展示,没有覆盖全部物体与任务的统计。
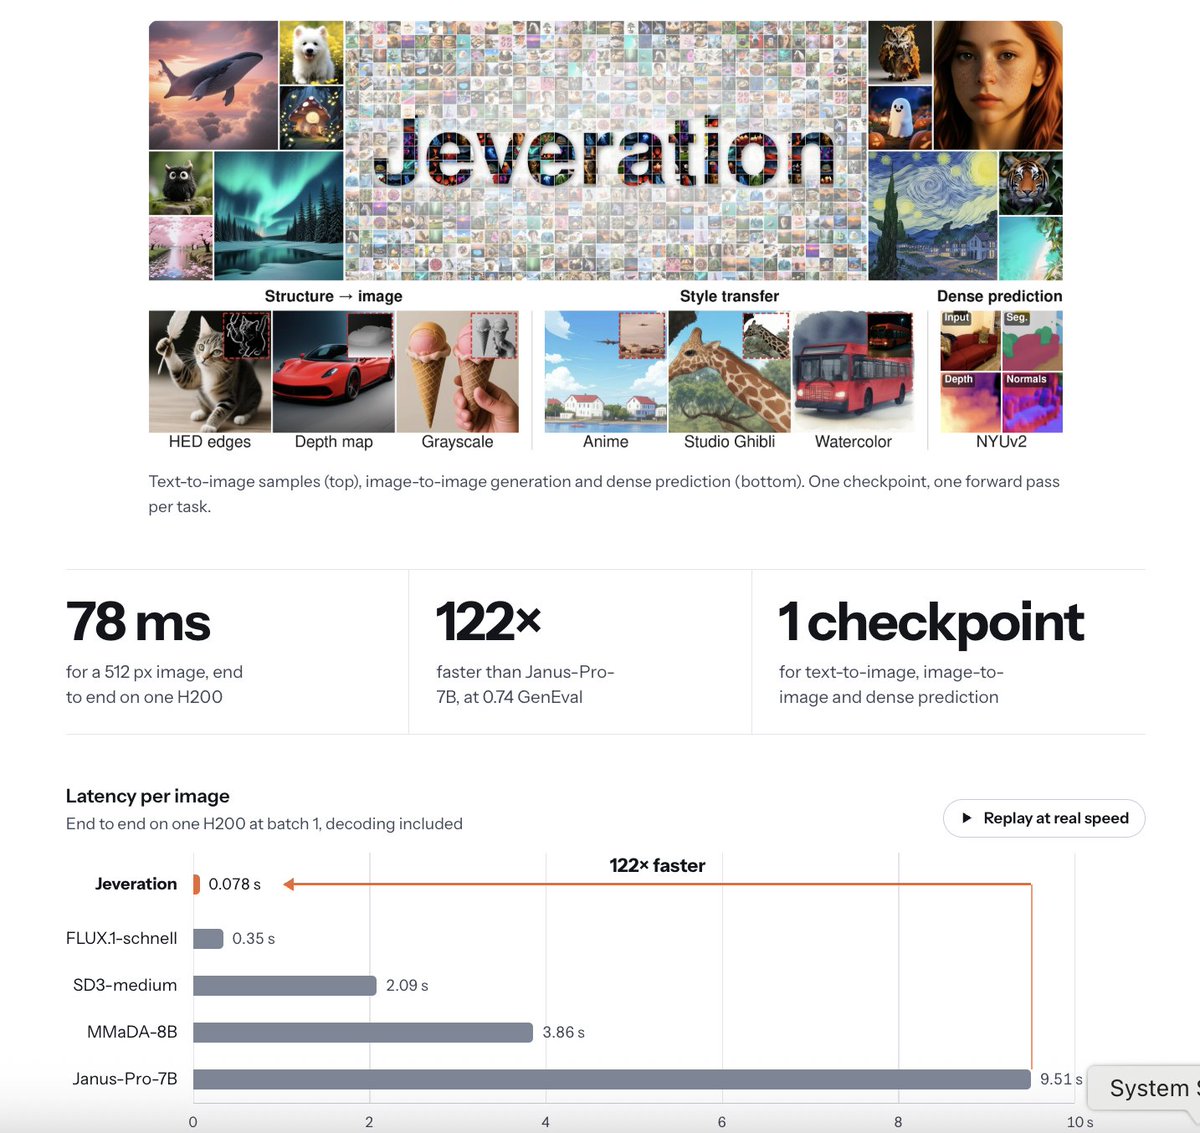
Jeveration:冻结视觉模型也能单次出图
论文用共享随机状态协调并行预测,将冻结视觉语言模型用于单次前向图像生成,并统一图生图、密集预测。作者报告 512×512 图像耗时 78ms;最高 122 倍加速是相对所比统一模型的实验结果。
UltraTex 将材质知识引入 PBR 纹理
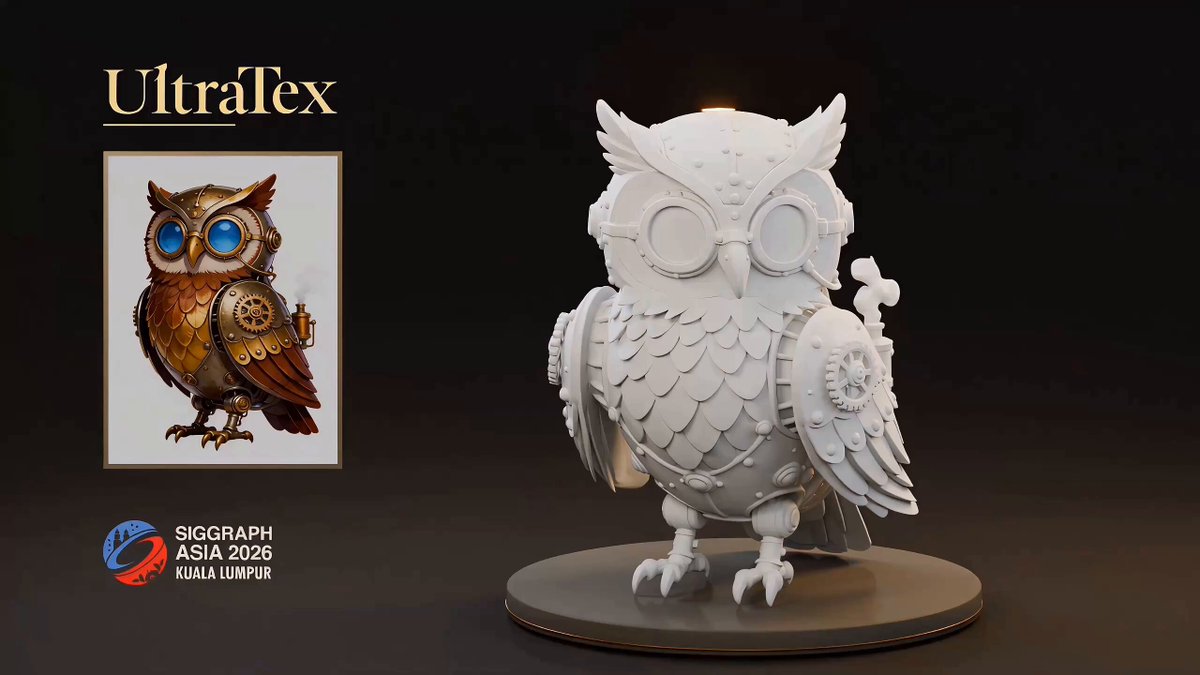
UltraTex 用级联多视图方法从单张参考图生成 PBR 纹理,先预测反照率和法线,再预测金属度与粗糙度。方法通过视觉语言特征和光度对齐,减少把光照误当材质的歧义。
Invoker-Render 展示 30 分钟可控视频
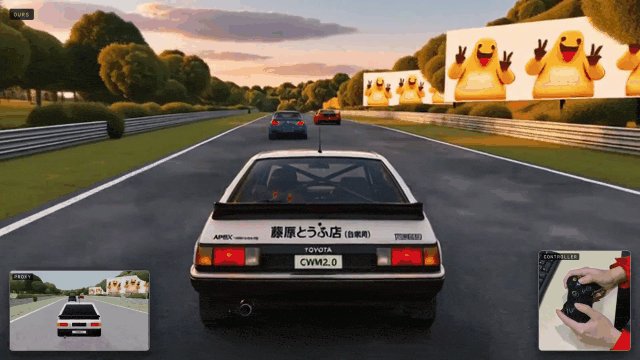
Code World Model 2.0 的 Invoker-Render 将结构代理、参考图与文本接入统一渲染接口,并用四步流式模型和 Progressive Forcing 抑制漂移。作者展示了 30 分钟赛车推演,不能据此认定任意场景都可无限稳定生成。
JEPA 研究世界的潜在地图
Yann LeCun 转发新论文,问题是 JEPA 能否学习世界的潜在地图。当前采集材料确认研究方向与参与作者,但不足以补写导航性能或泛化结果。
Game2Player 联合构建环境与玩家
论文动态介绍 Game2Player,由 UIUC、IBM 等机构参与,将可验证网页游戏环境与玩家共同开发,用于扩展视觉交互研究。采集到的简介被截断,当前不追加规模或分数。
Prime Intellect 推出 Model Factory
Omar Khattab 转发 Prime Intellect 的 Model Factory,介绍在同一套平台训练、部署并持续改进自有模型。当前材料只确认产品工作流,不补写算力价格或兼容清单。
Gradio 7 计划减少一半依赖
Abubakar Abid 表示 Gradio 7 将把依赖数量减少一半,强调每个依赖都可能带来漏洞风险。这里记录的是版本计划;依赖减少并不能单独证明漏洞数量同比下降。
PyBot 的 Rust 移植开放协作细节
Lewis Tunstall 转发 rsbot 移植案例:作者称 25 个 Claude Code 智能体参与、成本约 1,400 美元、速度提升约十倍。当前采集材料未完整说明测试条件,数字按作者自报理解。
零权重 Python 程序参与数学测试
研究动态称一个纯 Python、零权重程序在 GSM8K 得到 15.2%,所引用 Llama 2 70B 对照为 11.6%。这是特定数学测试中的比较,不能扩大为全面超过大语言模型。
Hugging Face Jobs 用于异步 RL 实验
Lewis Tunstall 转发在 Hugging Face Jobs 上测试 AsyncGRPO 与 Qwen3-30B-A3B LoRA 的案例,配置涉及三个 vLLM 作业和两个训练作业。动态展示作业编排方式,未给出完整最终结果。
可解释性与安全的关系进入综述
Sara Hooker 转发跨机构综述,讨论理解模型内部机制是否使模型更安全。采集摘要提供研究问题,尚不足以归纳所有方法的统一结论。
Pika Enact 探索播放中的导演操作
Pika 团队介绍 Enact 研究预览:场景播放时,用户可移动 AI 演员、给指令并调整镜头,减少提示框与导演操作之间的距离。当前是交互创作演示,不写成所有用户均已全面可用。
Synthesia 视频工作流进入 Claude
Synthesia 宣布 Claude 连接器:在聊天中描述所需视频,由服务生成、播放并按要求修改,还可分享链接或配置自动化。视频能力由连接服务提供,用户可在现有对话中完成流程。
Kling 4.0 增加原生 4K 与 HDR
Kling 官方称 4.0 支持原生 4K,并在 4K 和 1080p 输出提供 10-bit HDR。链接主页没有展开全部技术条件,具体模式和账户可用性以产品为准。
PixVerse 接入 ChatGPT Images 2.6
PixVerse 宣布接入 ChatGPT Images 2.6,并介绍从提示或图片生成动画 GIF 的入口,区分 Flare 的速度和 Sunburst 的质量定位。订阅附带的 Relax Mode 权益按平台公告条件执行。
MiniMax H3 Image 展示科研图制作
PixVerse 分享用 MiniMax H3 Image 制作科研图、图表与标签的例子。演示展示视觉表达与文字可读性,图中数据、标注和科学关系仍应由作者核对。
Recraft 将参考风格保存到后续提示
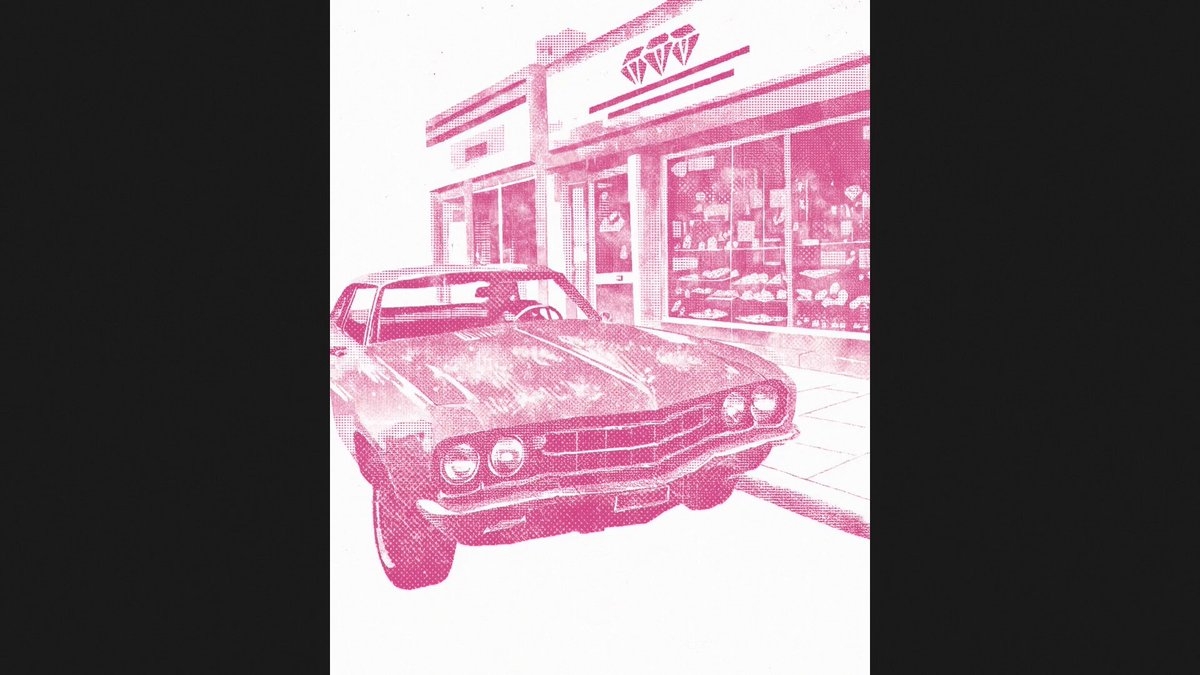
Recraft 演示添加一张或多张参考图后保存风格,让后续提示延续同一视觉方向。这是参考素材复用工作流,效果仍取决于参考与生成内容。
Fable 驱动 Houdini 花朵场景制作
Higgsfield 分享 Fable 5.2 与 Houdini 的创作案例:40 秒影片包含约 25,800 朵花,作者称用八张租赁 GPU 渲染约 90 分钟。影片时长与渲染时长是两个不同指标。
Blender 机甲案例区分建模与渲染
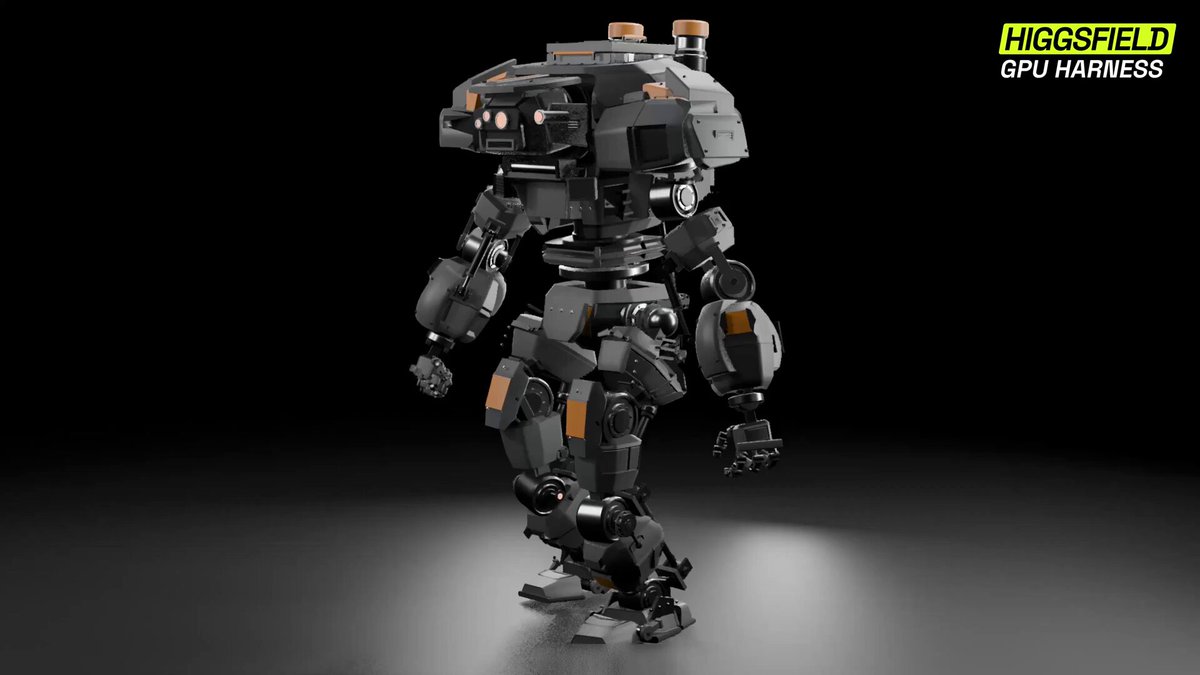
Higgsfield 展示 Fable 5.2 在 Blender 制作 184 个部件的机甲,并租用 GPU 渲染行走。公告自报 14 分钟、17 credits,未提供完整计费范围,作为单个创作案例记录。
Genie 4 演示探索时实时改场景
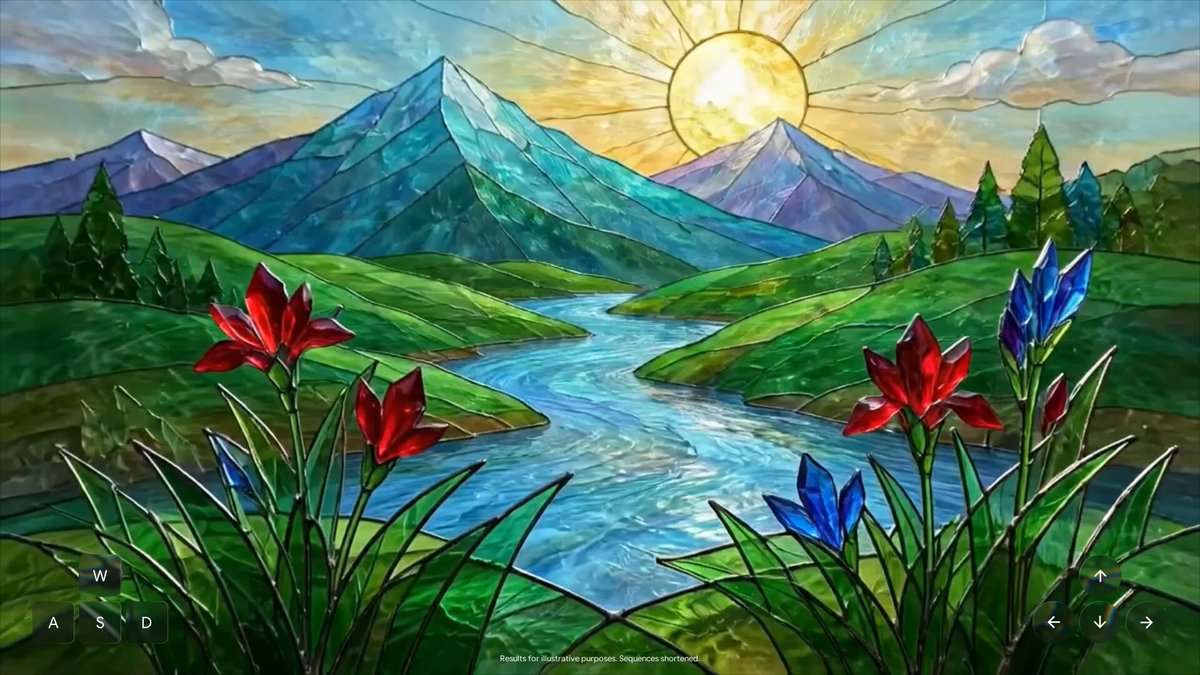
Sundar Pichai 展示 Genie 4 在探索生成世界时接收新提示、加入角色或改变场景,原生音频同步适配。功能面向符合条件的 Google AI Ultra 用户;这条补充交互细节,不当作第二次模型首发。
Gemini 4 Neon 进入成本能力比较
宝玉介绍 Neon 的 Artificial Analysis 智能指数与价格对比。模型此前已发布,这里记录其成本与能力的比较讨论;榜单分数取决于当时版本、设置和样本,不能代替自己的任务测试。
Neon 的多模态界面案例增加
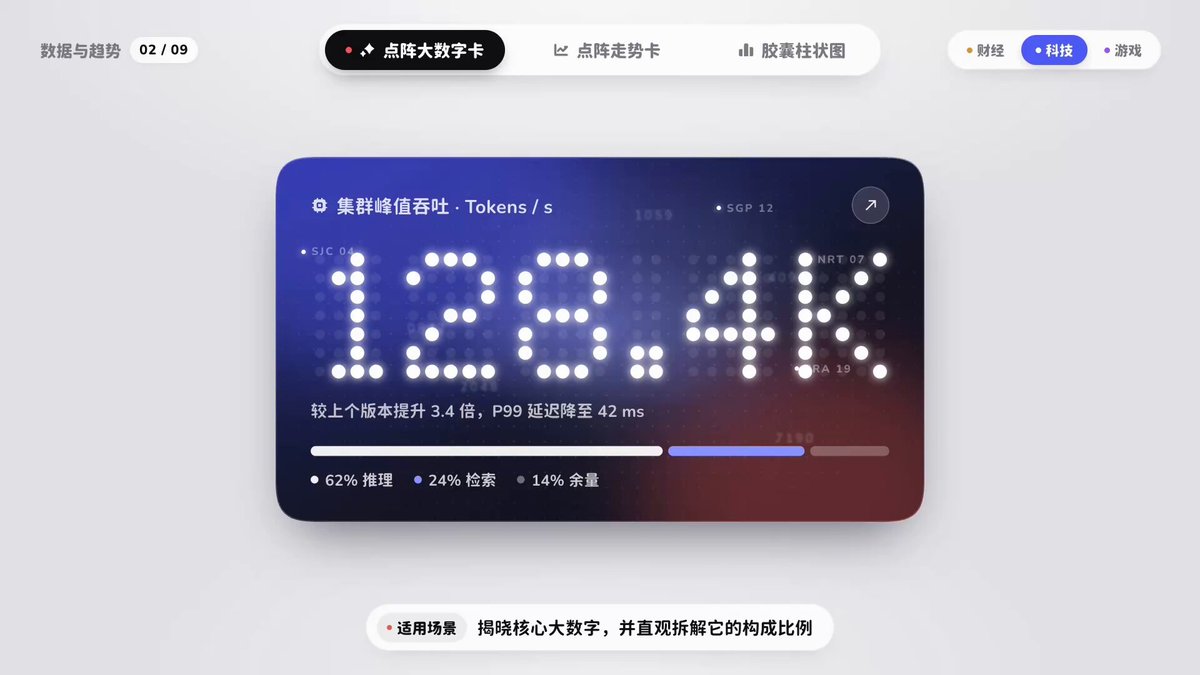
归藏分享根据参考图生成组件与动效的 Neon 演示,并认为在自己的任务中可替代 Opus 5.5。该判断是个人工作样本,不能当作模型全面排名。
表格公式也能表达视觉计算
fofr 与合作者用 Neon 在 Google Sheets 中按单元格显示像素,并用公式计算深度、Canny 边缘与重着色。案例展示电子表格作为可检查计算媒介的可能。
从像素角色到可探索 3D 房间
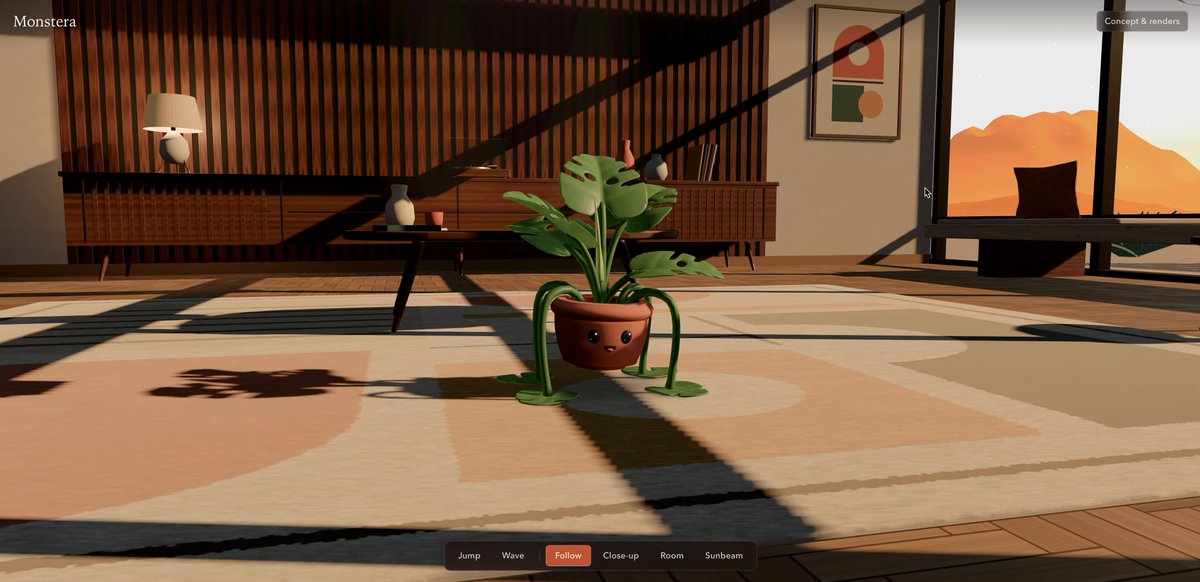
fofr 分享 Neon 将龟背竹像素角色转为高保真 3D 概念,并放进可走动的现代室内环境。它展示跨表示创作流程,当前没有可重复成功率统计。
GPT-6.2 参考图生成童话小镇
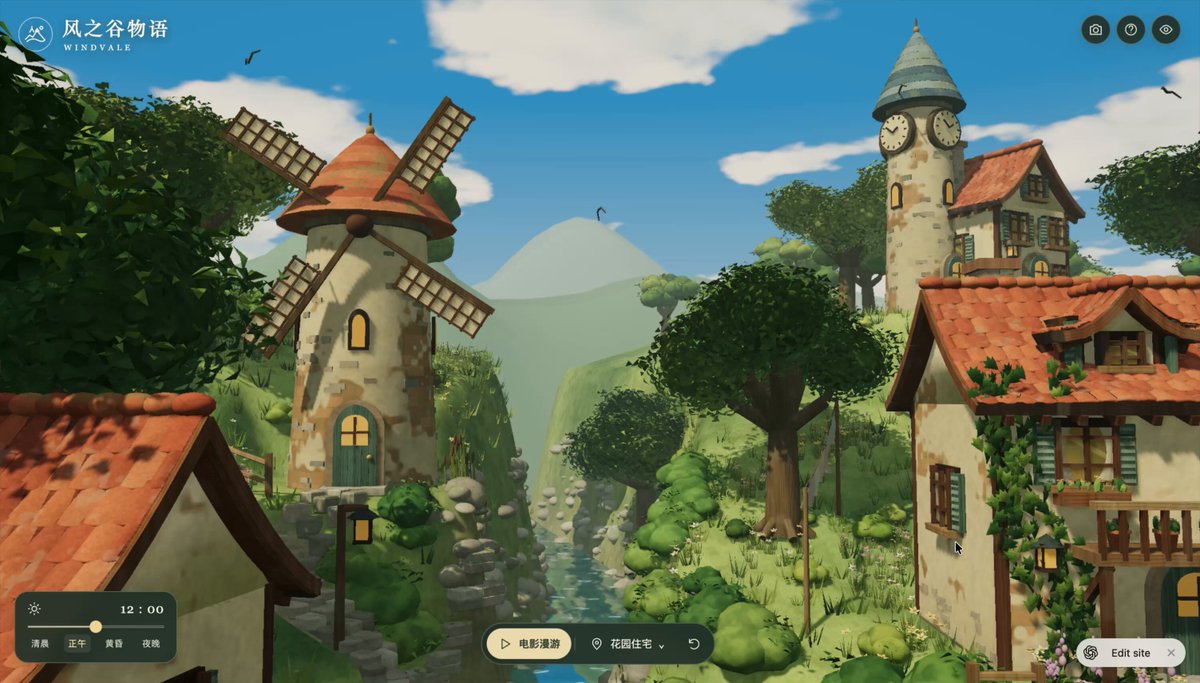
OpenAI 开发者账号转发创作者用 GPT-6.2 从一张参考图制作 3D 小镇的案例,包含八栋可走近的房屋和动态细节。结果属于个人作品展示,不是统一游戏开发评测。
同一提示比较程序化场景的变化
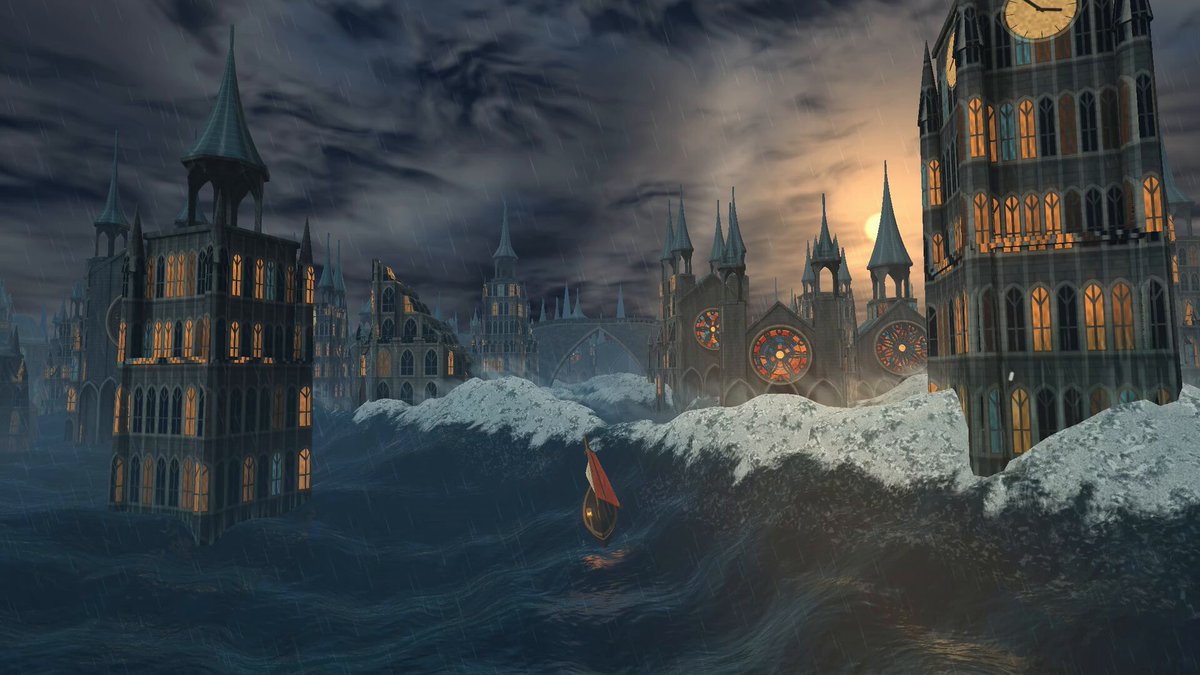
Ethan Mollick 用此前相同提示,在 GPT-6.2 Astra 上生成淹没的新哥特城市着色器,并记录确定性元素的加入。它是一组个人对照案例,不能单独量化模型整体进步。
Tripo 强调生成之后的 3D 编辑
Linus Ekenstam 介绍 Tripo Agentic Canvas,强调 3D 工作中的编辑、变体和跨工具衔接,而不只是首次生成。该条属于产品介绍,未附独立速度或质量评测。
RGBMocap 增加 MetaHuman 实时流
CoffeeVectors 转发 RGBMocap 的 Unreal Engine MetaHuman 实时流支持,可边传输动作边记录。当前动态确认集成方向,没有给出延迟、跟踪精度或硬件配置。
AI Gateway 的支出结构出现变化
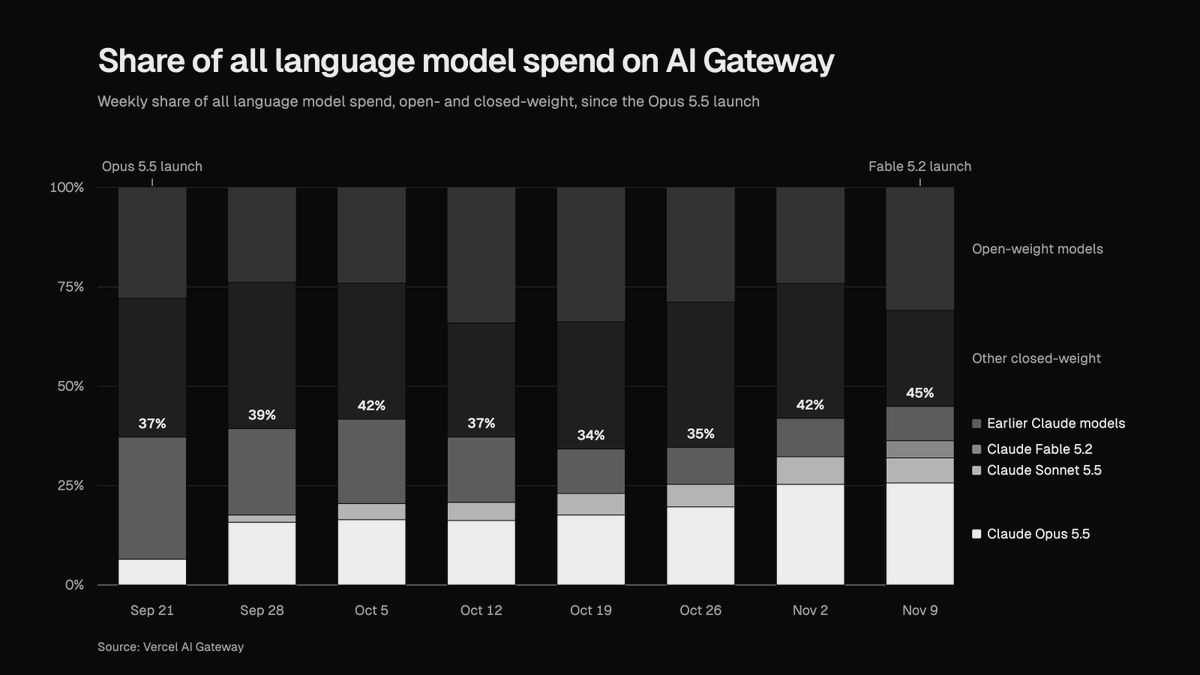
Vercel 称 Anthropic 在其闭源模型支出中的占比从 52% 升至 65%;另称开放权重模型占网关总支出从 2% 升至 29%。两组分母不同,不能相加或当作全行业份额。
ParseBench 承认旧评分存在错配
LlamaIndex 以财报金额解析为例,解释 ParseBench-1 曾把破坏金额的解析结果排在正确结果之前。动态强调基准也需检查具体错误,避免只看总分选择文档解析器。
企业模型讨论转向数据去向
Ollama CEO Jeffrey Morgan 表示,与 CIO 和工程负责人交流时,问题正在从模型运行地点转向数据去向。这是其企业访谈观察,反映部署选择中的数据治理关切。
鹈鹕测试比较同家族不同推理档位
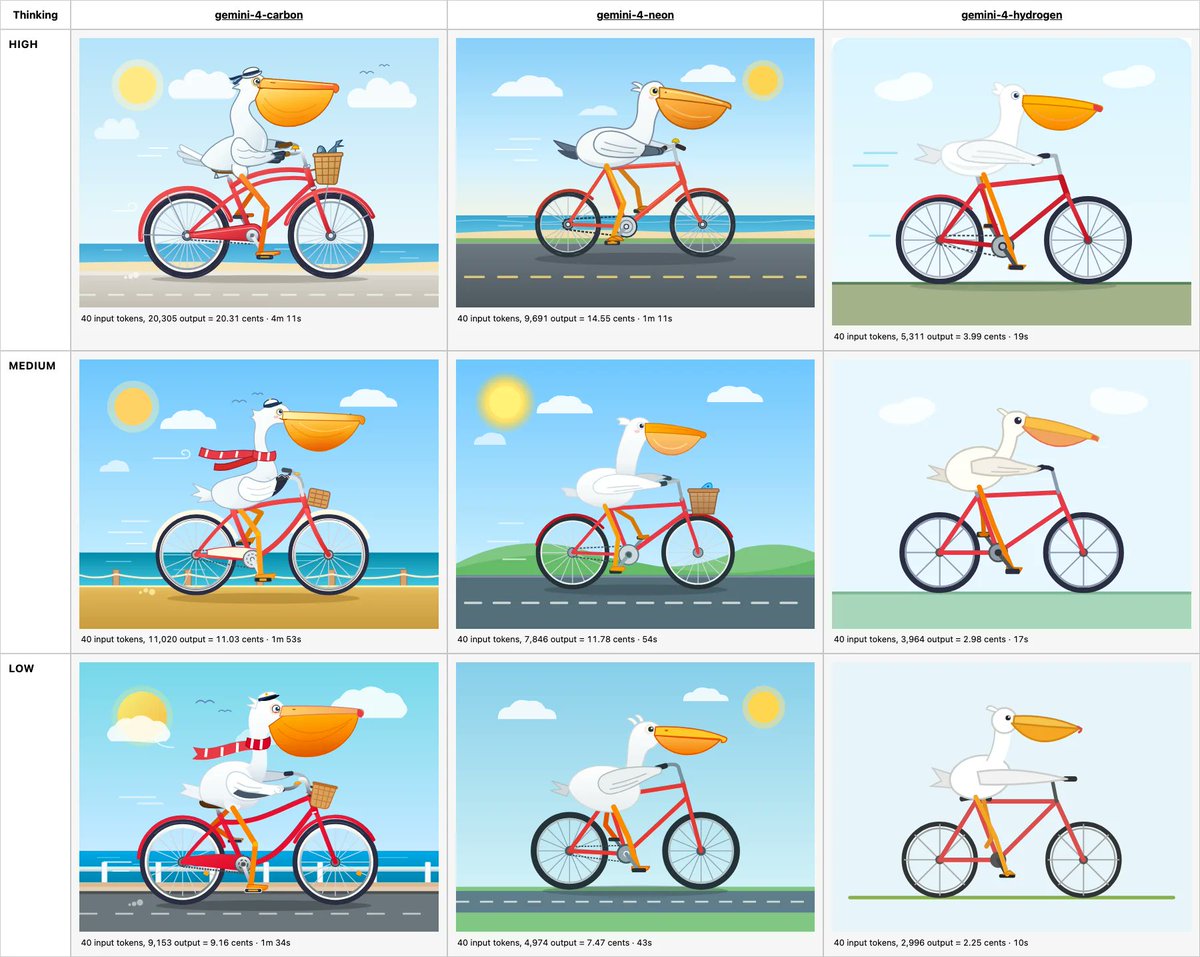
Simon Willison 用骑自行车的鹈鹕提示,对比 Gemini 4 Carbon、Neon、Hydrogen 在不同 effort 设置下的结果。他强调这类小测试可显示配置差异,不能覆盖模型所有能力。
安全修复与 AI 导致故障需要区分
Arvind Narayanan 认为,近期一些涉及 AI 的停站,其实是防守方发现并修补长期漏洞、部署更新的结果。他提醒讨论事故时区分发现问题、修复部署和引入新故障。
用户自带智能体带来产品权限问题
Ethan Mollick 认为,公司若禁止用户用自己的智能体管理账户或电脑,可能引发客户不满。该观点指向产品权限与用户控制权的冲突,并非已验证的普遍用户反馈。
AI 自动回复名单引出治理讨论
Pieter Levels 发布自动化 AI 回复账号名单,称有 3,728 个账号、498 个已被暂停。页面提供人工审核的申诉和举报流程;这些数字来自维护者,不是平台独立统计。
Koray:可靠性比单一 AGI 测试更重要
Google DeepMind 的 Koray Kavukcuoglu 认为,不会有一个测试能宣告 AGI 到来;更有意义的进展是模型能力不再忽高忽低,并在日常任务中更可靠。这是研究者对进展衡量的观点。
Denny Zhou:模型与数据的关系在变化
Denny Zhou 提出一个观察:过去最好的数据塑造最好的模型,如今更强模型又能生成更好的数据。这是对模型与合成数据反馈关系的概括,不是所有训练数据都可被替代的结论。
Jason Wei 关注新的测量方法
Jason Wei 认为,当 AI 能优化可量化目标时,新的价值也来自如何测量世界。观点提醒开发者先审视指标是否代表真正需求,而不只追求已有分数。
Mistral 预告伦敦 Le Chonk 黑客松
Mistral 将于 11 月 21 日在伦敦举办一天的 Le Chonk 黑客松。活动页面列出 18 岁以上、三至五人组队等条件,参与者需查看报名页确认细节。
Mistral 与 ClickHouse 合办巴黎活动
12 月 5 日的巴黎黑客松围绕可预测并行动的智能体,开发工具包括 Le Chonk、Timestral、ClickHouse 和 Langfuse。活动需提前报名。
RL Residency 为独立研究提供资源
Omar Khattab 转发 Prime Intellect 的 RL Residency,介绍面向独立研究者的算力资助和导师支持,方向包括开放评测与训练环境。具体申请条件仍需参考项目公告。
图解 Agent Skills 英文版进入预售
宝玉介绍《An Illustrated Guide to Agent Skills》英文版预售,围绕把日常重复任务做成可复用工作流。商品页面列出的发售日为 2027 年 2 月 9 日,不写成已经正式发售。